Loading...

調査・分析文章・文書

判定モデル · Jev

メール500通を任せたら、AIが25秒で返信すべき23通だけを選び出してくれました

Jevは文章を書く代わりに、選択肢から1つを選ぶ、はい・いいえで答えるといった判断に絞ったモデルです。そのぶん速く、安く動きます。受信箱、スクリーンショットのフォルダ、あるブランドの広告1,891本、メディアの評価責任者による「AIっぽさ」チェックまで、4人が任せた仕事を集めました。

2026年9月30日·事例 4件

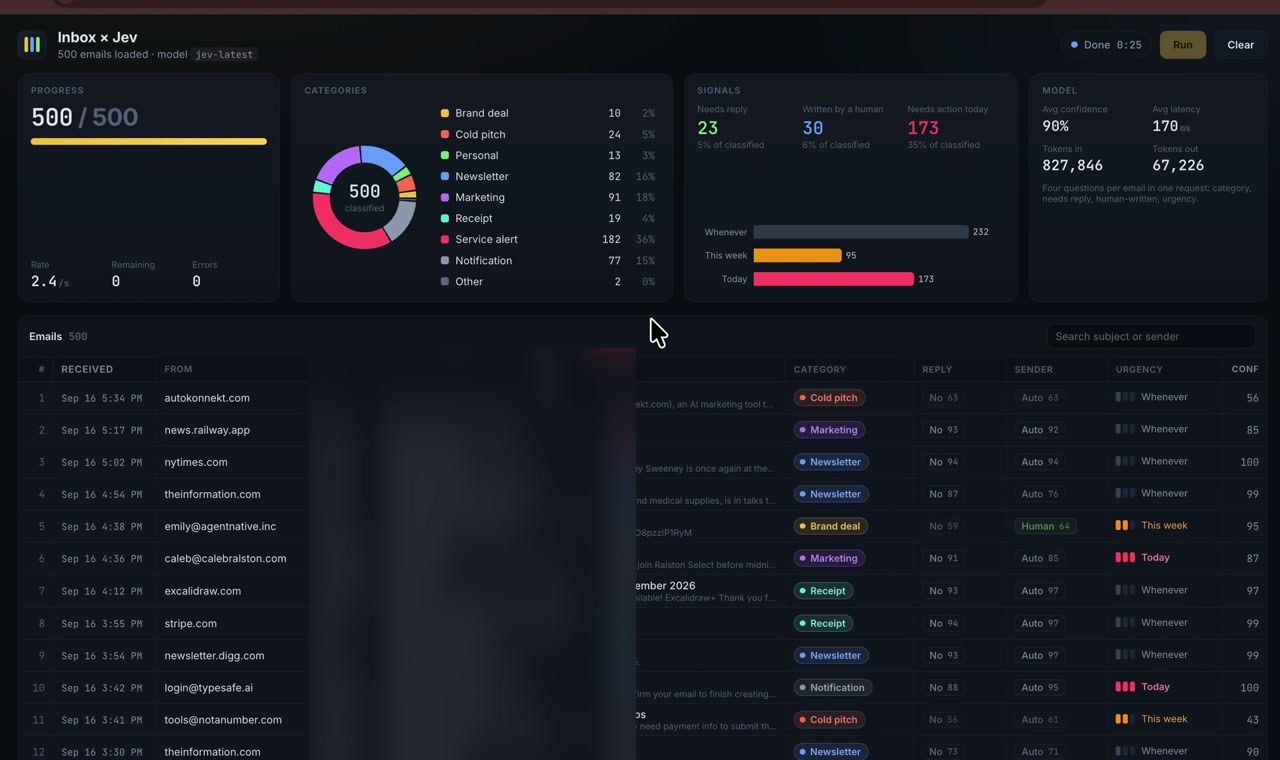
Inbox × Jevの画面。メール500通を25秒で仕分け、種類ごとの件数、返信が必要なメール23通、緊急度が表示されている
Riley Brown氏が作ったInbox × Jevの画面。メール500通の仕分けが25秒で終わりました。件名とプレビューはぼかしてあります。

AIに任せる仕事の多くは、実は文章を書くことではなく判断です。このメールに返信は必要か、この広告はどんな顧客を狙っているのか、このキャプチャはどのフォルダに入れるべきか。ところが、こうした判断もChatGPTやClaudeのようなモデルに任せると、答えを文章で書き出すぶん1件に数秒から数十秒かかり、数千件を回せば費用もすぐに膨らみます。

9月15日にTypeSafeが公開したJevは、文章をまったく書きません。あらかじめ決めた選択肢から1つを選ぶ、はい・いいえで答える、点数を付ける。そのうえで、その答えにどれだけ確信があるかを確率で一緒に返します。 料金は入力100万トークンあたり0.042ドルで、返す答えには料金がかかりません。

作ったのは、ChatGPTの土台となったInstructGPT論文の共著者、Diogo Almeida氏です。 同氏のローンチ投稿はXで表示回数3,980万回を超え、3日のうちにVercel・Cloudflare・OpenRouterが自社サービスからJevを呼び出せるようにしました。 9月20日にウェイトリストを撤廃したものの、登録が殺到して2日後に新規登録を止め、9月27日に再開しています。 9月29日には、OpenAIが同じ役割のDecisions APIをプレビュー公開しました。決めておいた答えの中から1つを選ぶAPIで、テキストだけでなく画像も受け付けます。

安くて速い判断が手に入ると、人々がまずJevにかけてみたのは、それまでたまる一方だったものでした。受信箱、スクリーンショットのフォルダ、広告ライブラリ、過去の記事です。
Reference 01クリエイターのRiley Brown · 自分の受信箱

メール500通を渡したら、25秒で返信が必要なメールだけを選び出してくれました

Riley Brown氏は、自分の受信箱のメール500通を自作の画面に読み込み、Jevに任せました。1通につき1回のリクエストで、4つのことを尋ねています。どんな種類のメールか、返信が必要か、人が直接書いたものか、どれくらい急ぎか、です。

画面のタイマーは25秒で止まりました。500通はサービス通知・マーケティング・ニュースレターなど9種類に分かれ、返信が必要と判定されたメールは23通、人が書いたメールは30通でした。同氏が明かした費用は3.5セントで、返信欄では、リクエスト1,000件で7セントかかったと補足しています。

画面に書かれた質問の構成

Inbox × Jev · 2026-09-17

Four questions per email in one request: category, needs reply, human-written, urgency.

メール1通ごとに1回のリクエストで4つを尋ねます。種類、返信が必要か、人が書いたか、どれくらい急ぎか。

Reference 02Cloudflareの開発者教育担当 Fayaz Ahmed · 自分のスクリーンショットフォルダ

数か月分のスクリーンショット970枚が、40秒で旅行・仕事・支払いのフォルダに自動で分かれました

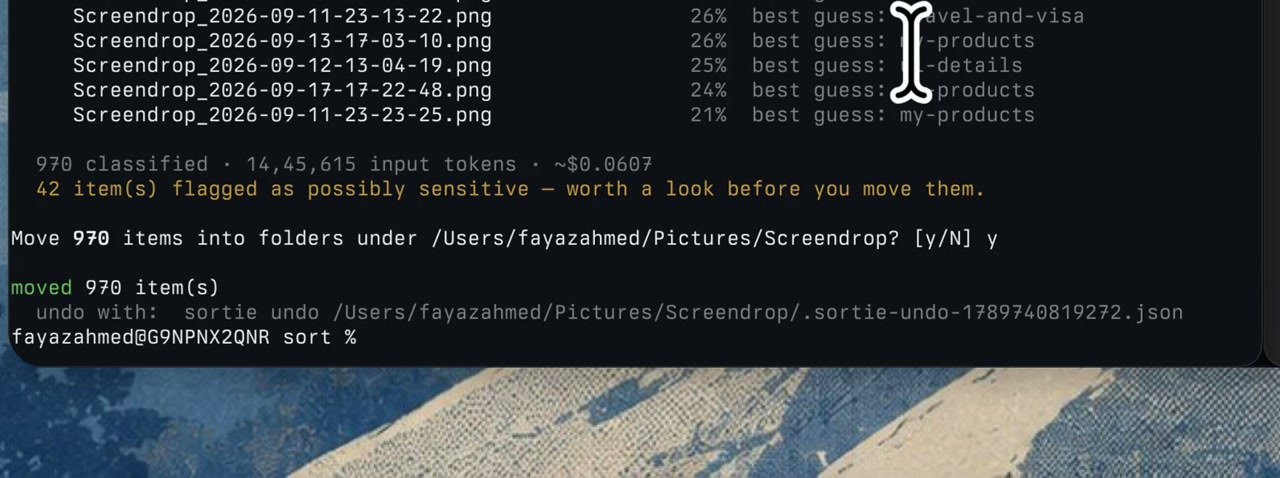
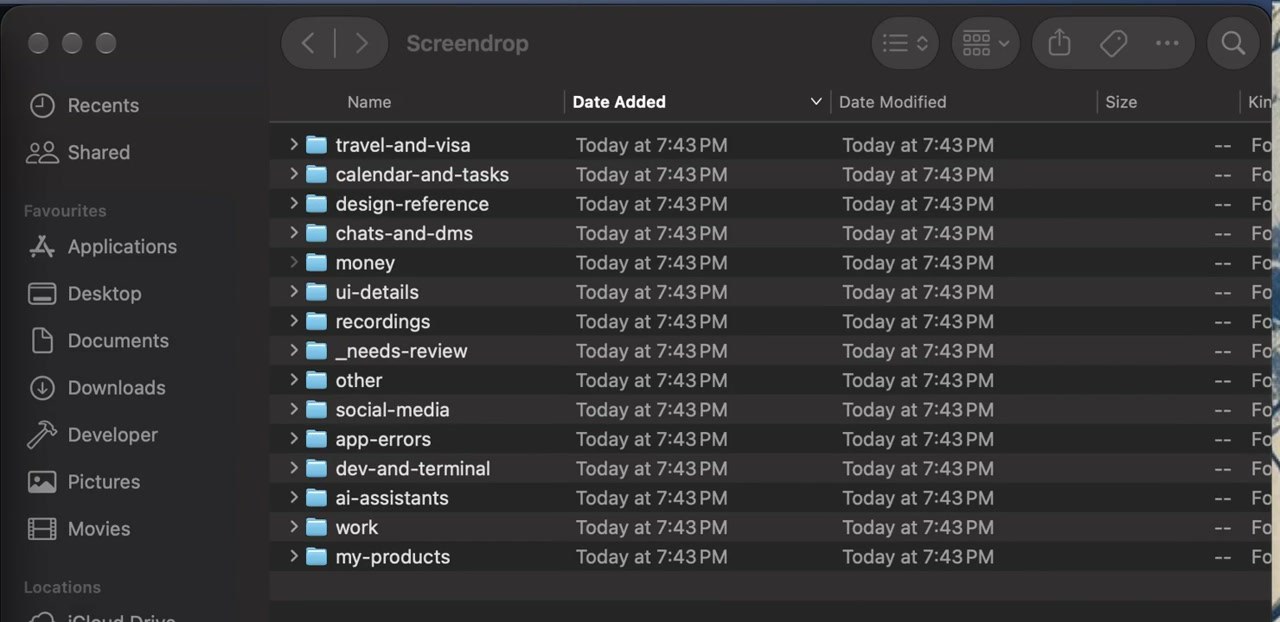
Fayaz Ahmed氏のMacには、スクリーンショットアプリが数か月かけて保存したキャプチャが970枚たまっていました。同氏はMacに標準搭載の文字認識でまず画像内の文字を抜き出し、その文字をJevに読ませてフォルダを選ばせました。Jevは画像を見ず、文字だけを読みます。

仕分けにかかったのは40秒ほどで、費用は約6セントでした。ファイルを移す前に確認を取り、機密に関わりそうなキャプチャ42枚には別に印を付けました。移動後には、一括で元に戻すコマンドも残しています。

Finderの画面。Screendropフォルダの中に、travel-and-visa、calendar-and-tasks、money、workなど15のフォルダが新しくできている
仕分けが終わったあとに新しくできた15のフォルダ。出典:Fayaz Ahmed、X(2026-09-18)
ターミナルの画面。970枚の仕分け、費用約0.0607ドル、機密の可能性がある項目42件、移動の確認と元に戻すコマンド
970枚の仕分け、約0.06ドル、機密の可能性がある項目42件、元に戻すコマンド。確信度の低いファイルには推定確率が付いています。

Reference 03マーケティングAIツールMaxfusionのStav Zilbershtein · 自社ツールのデモ

あるブランドの広告1,891本を任せたら、19秒でカスタマージャーニーの段階ごとに分けてくれました

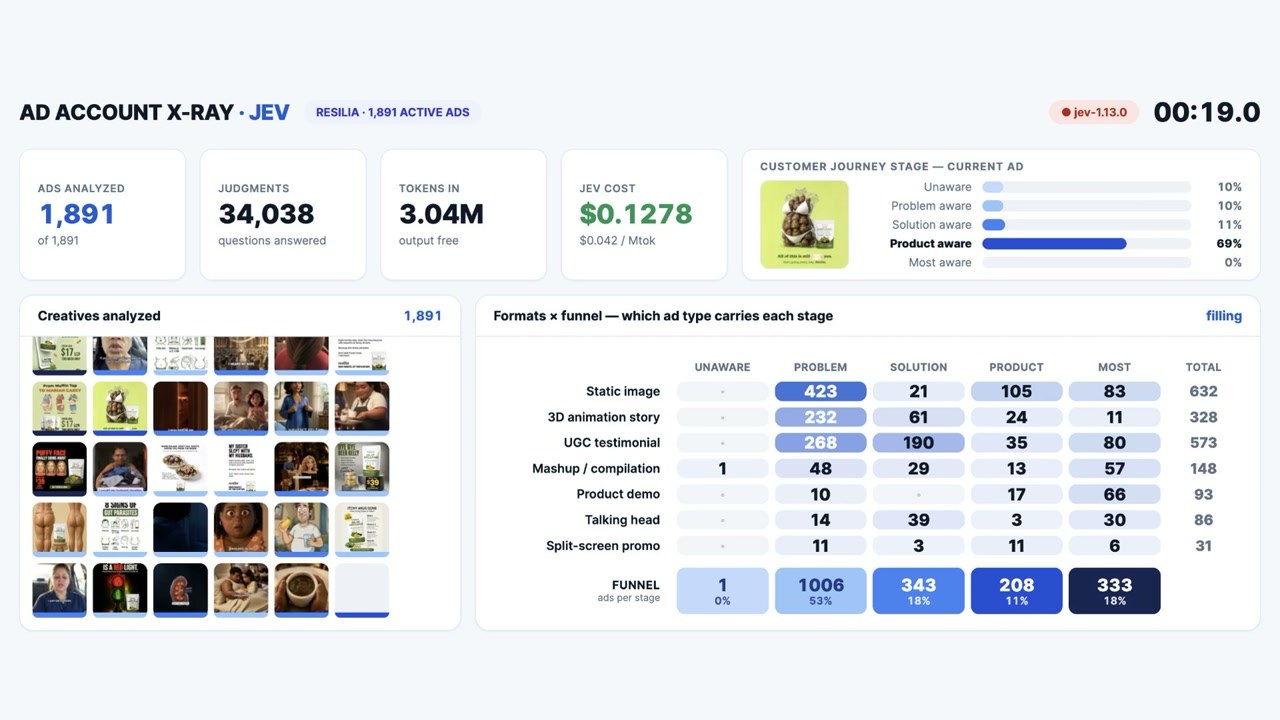
Stav Zilbershtein氏は、Resiliaというブランドが広告ライブラリに載せている広告1,891本をJevに任せました。広告ごとに、カスタマージャーニーの5段階のどこを狙っているか、どんな形式の広告かを尋ねています。5段階は、課題に気づいていない人から、購入の準備ができた人までです。広告画像はまずGeminiが文章に書き起こし、Jevはその文章を読んで選びました。

19秒で34,038件の判断が出て、費用は13セントでした。広告の半分を超える1,006本が課題に気づいた人を狙っており、購入の準備ができた人を狙った広告は333本でした。同氏は、この機能を自社のツールに組み込む予定だと明かしています。

AD ACCOUNT X-RAYの画面。広告1,891本、判断34,038件、費用0.1278ドル、19秒。広告の形式とカスタマージャーニーの段階を掛け合わせた表
広告の形式(縦)とカスタマージャーニーの段階(横)を掛け合わせた表。出典:Stav Zilbershtein、X(2026-09-18)

Reference 04米メディアEveryの評価責任者 Mike Taylor · 自分の記事27本

編集部の「AIっぽさ」チェックリストを記事37本に一度にかけたら、1秒もかかりませんでした

EveryはAIとの働き方を扱う米国のメディアで、ローンチの1週間前からJevを先行して試していました。評価責任者のMike Taylor氏は、自分が書いた記事27本と、わざとAIの文体で作った記事10本をJevに入れました。質問は、Everyが記事のAIっぽさを見抜くために使っていたチェックリストから選んだ21個です。777件の判定が0.7秒以内に返り、費用は0.25セントほどでした。

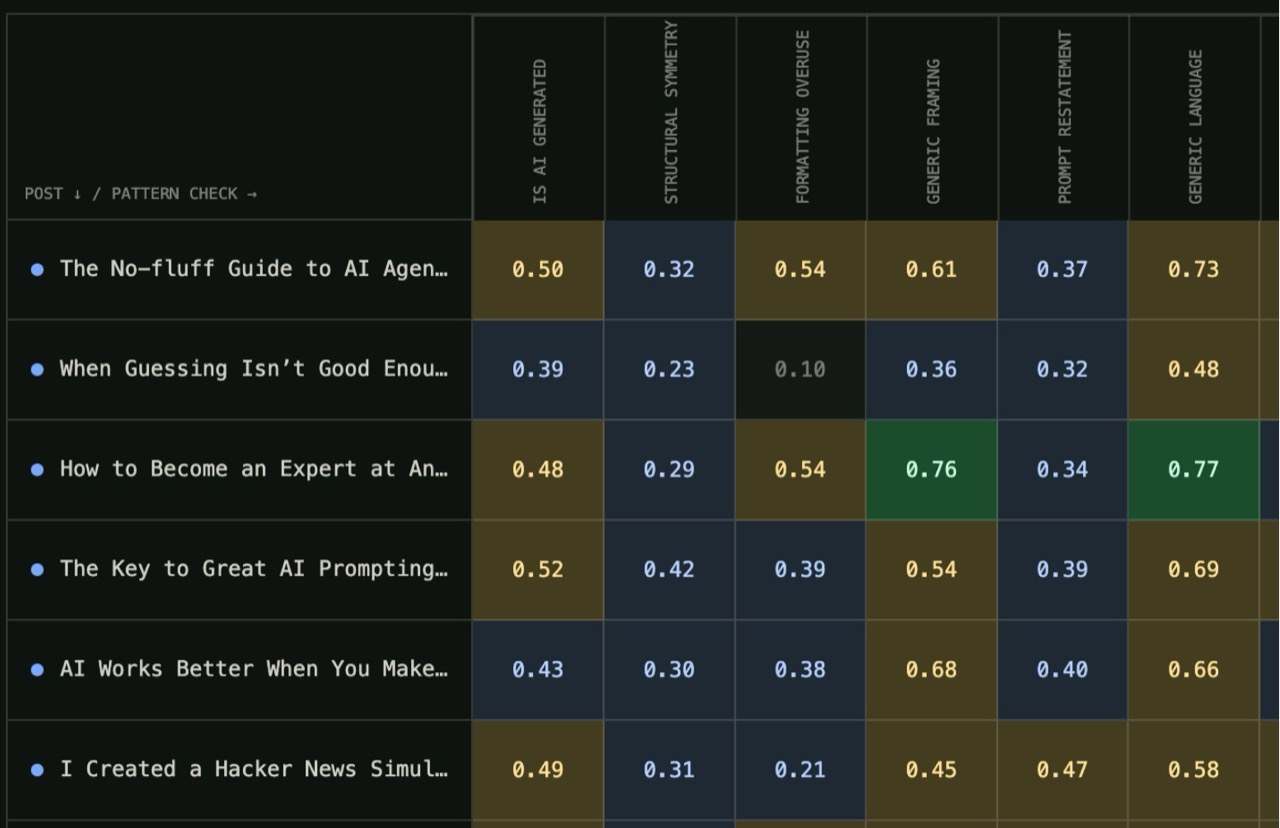
ただし、文体パターン一つひとつの点数を平均する方法はうまくいきませんでした。Mike氏の実際の記事も、整えた構成や修辞の型を使っているため、平均点がAI文体の記事よりむしろ高く出たのです。 CEOのDan Shipper氏が別に行ったテストでは、わざと仕込んだ欠陥7つのうち6つを見つけました。同じテストでClaude Fable 5.1は7つすべてを見つけましたが、Jevは25倍ほど速く、費用は約580分の1でした。

Mike氏は、実際に使う前に精度をもっと確かめたいとしながらも、まったくチェックしないよりは、最初に鳴る警報として使う価値があると書いています。

行が記事のタイトル、列がIS AI GENERATED、STRUCTURAL SYMMETRYなどのAI文体パターンで、各マスに0〜1の確率が書かれた表
行は記事、列はAI文体のパターンです。1に近いほどAIっぽいと判定したことを表します。出典:Every(スクリーンショットはMike Taylor氏提供)
Everyが投げた21の質問のうち5つ
  1. 1Does this writing appear likely to have been generated primarily by an AI? Judge only the text, not its topic or author metadata.
  2. 2Does the writing rely on generic framing instead of concrete context?
  3. 3Does the writing explain straightforward points more than necessary?
  4. 4Does the writing repeat the same idea without adding new evidence?
  5. 5Does the writing end with a generic offer to help or continue?

21個すべては、Everyの実験サイトで見られます。

みんなの反応

速度と料金については、称賛が圧倒的です。精度は意見が分かれます。選択肢がはっきりした分類なら小さなLLMと同等かそれ以上だという人もいれば、微妙な判断やセキュリティの判断ではHaikuやGeminiより低かったという人のほうが多くいます。「0.8と答えたら8割は当たる」という確率の主張には、反例がたくさん出ました。いちばん多かった結論は、Jevを一次フィルターに使い、判断が難しいものは大きなモデルか人に回せ、というものです。

公式サイトは193.6倍速く444.6倍安いとうたっていますが、ローンチ後4日間にユーザーがXに書き込んだ数値を集めると、速度は中央値で7倍、料金は30倍でした。

よかったという声

  • “Probably around 750,000 classification problems, cost 26 cents and it did great job.”

    レシピ集にタグを付ける分類、約75万件で26セント。結果も上々だったそうです。

    u/natlight · Redditreddit.com
  • “737 predictions had ≥99% confidence. Every one matched the reference label. Below 70% confidence, nearly half were wrong.”

    確信度99%以上の737件はすべて正解で、70%未満は半分近くが外れました。人が見直すべきものを選ぶのに役立ったそうです。

    Nikhil Mudholkar(Bryo CTO) · Xx.com
  • “On Korean medical questions, taking only its most confident half cuts the error rate from 20% to 2%.”

    韓国の医師国家試験の問題で、確信度の高い半分だけを採用すると、誤答率が20%から2%に下がりました。

    MahlerLab · 医療データ研究者ahn-lab.org
  • “Claude, codex 등 플러그인으로 사용해 봤는데 검증 결과가 나오는 속도가 장난 아닙니다.”

    ClaudeやCodexなどのプラグインとして使ってみましたが、検証結果が出るスピードがとんでもないです。

    @parktaegyun · YouTubeコメントyoutube.com

物足りなかったという声

  • “Jev's own verdict loses clearly on accuracy (McNemar p < 0.0001) and wins on speed and cost.”

    フィッシングメール2,000件で、Jevの正解率は62.6%、Haikuは81.3%でした。2行の正規表現ルールは91.6%でした。

    anisselbd · GitHubgithub.com
  • “Jev always chose face 1 and the probability it returned was about 83%”

    公平なサイコロの出目を400回尋ねたところ、毎回1を選び、確率は83%ほどと答えました。

    kantahayashi · Hacker Newsnews.ycombinator.com
  • “Jev's median call was 6.3× faster than Sonnet's. Fast, but not 40–200×.”

    Sonnetより6.3倍速かったものの、公式の数字である40〜200倍には届きませんでした。

    dchristopoulos · Hacker Newsnews.ycombinator.com
  • “0.9 이상이면 확실하다고 판단해도 될 줄 알았다. 그런데 애매한 task에 오히려 높은 confidence가 찍히는 경우가 나왔다.”

    0.9以上なら確実と判断していいと思っていたが、曖昧なタスクにかえって高いconfidenceが出ることがあった。原因はJevではなく、選択肢の境界が重なるように組んだ自分の設計だった、と書いています。

    ブログ「チョコクッキーの練習帳」 · Tistoryjjeongil.tistory.com

始め方

Claude Code・Codex・Cursorのようなコーディングエージェントに下の依頼を貼り付けるだけです。Jevを呼ぶAPIキー(TypeSafe・OpenRouter・Vercel AI Gatewayのいずれか)はご自身で作成してください。

  1. はじめの依頼

    この記事のJevで、たまった文章をすばやく仕分けたい。 https://www.working-ref.com/ja/reference/jev-decision-model-2026-09 メール・問い合わせ・ファイルの中から、Jevに任せられそうな判断を3つ提案して。1つ選んだら公式スキルを入れてすぐ動かして。日本語の文章はまず数十件で精度を確かめ、数値計算と日付の比較はコードで処理し、確信の低い判断は私が確認できるように残して。選ばなければ、最初の事例のように、メールから返信が必要なものを絞り込むところから始めて。

    console.typesafe.ai ↗

このリファレンスを共有

毎週1回・無料

このリファレンスは役に立ちましたか?

毎週あふれるAIニュースから
BEST 3つだけ、受信箱へ

Work Smarter with AI

420人が毎週受け取っています

購読完了 次号から受信箱でお会いしましょう。