Loading...

方法 · 用AI智能体翻查历史档案

一名工程师让AI智能体翻查旧档案和旧报纸,找到了6份陨石目录都没有收录的1812年陨石坠落记录

把一堆已数字化的旧文献和一个问题交给AI智能体,它会按语义检索、筛出候选段落、阅读并翻译,再与原始扫描件对照。一位软件工程师用这种方法翻查旧文献和旧报纸,找到了一条1812年的陨石坠落记录,该工程师核对过的6份陨石目录都没有收录。历史学家Benjamin Breen在东印度公司档案中找到一条渡渡鸟捕猎记录,正好落在渡渡鸟目击年表中空缺的1611至1616年间。两人的发现都还没有经过专家确认。还有人只凭一张扫描件,读懂了一封217年来无人能读的密信。本文汇总了这些案例。

2026年10月13日·3 个案例

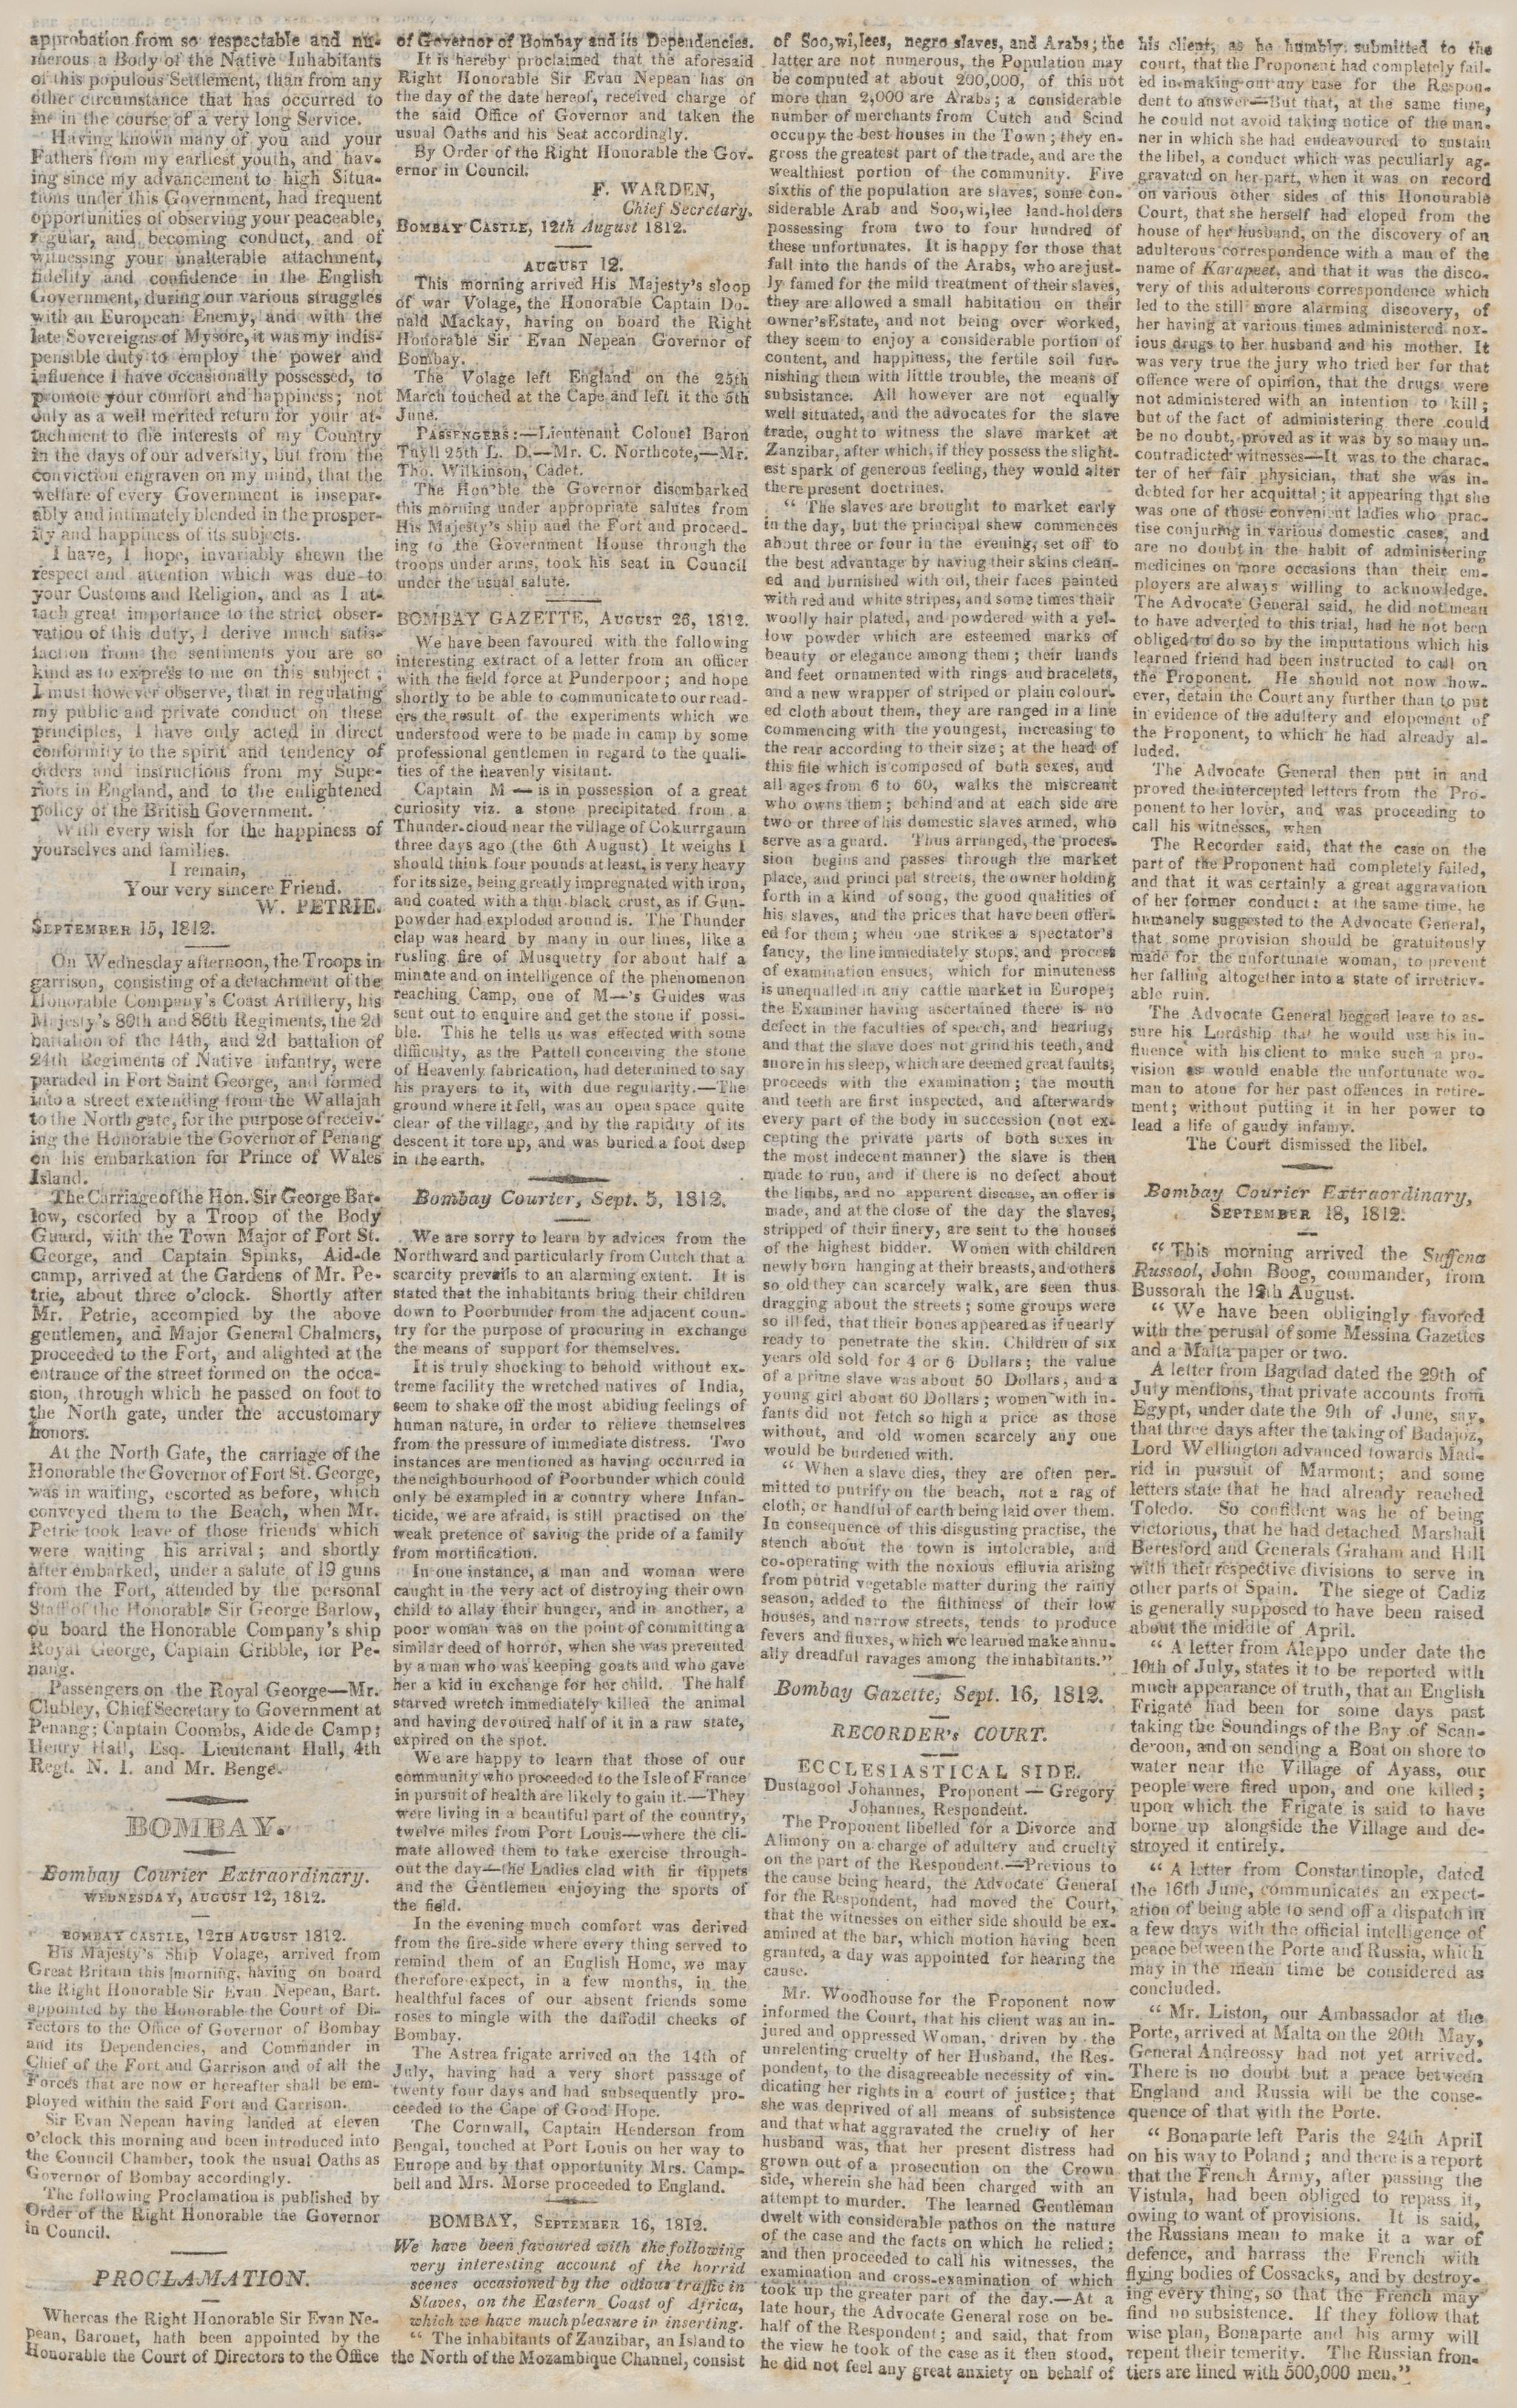
1812年Java Government Gazette版面局部。报道刊登了一封信,说Cokurrgaum村附近有一块石头从雷雨云中落下
1812年12月19日的Java Government Gazette第3版。上面记载的陨石坠落,Waites核对过的6份陨石目录都没有收录。原版面收藏于Delpher(荷兰皇家图书馆)。来源:Jesse Waites博客

开头那张版面是1812年12月19日Java Government Gazette的第3版。这篇报道转载了同年8月刊登在孟买一家报纸上的一封信,信中写道:"a stone precipitated from a Thunder-cloud near the village of Cokurrgaum three days ago (the 6th August). It weighs I should think four pounds at least(三天前的8月6日,Cokurrgaum村附近有一块石头从雷雨云中落下。我想它至少有4磅重)"。这是软件工程师Jesse Waites借助AI智能体翻查东印度公司档案和旧报纸时找到的报道。Waites核对过的6份陨石目录都没有收录这次坠落。

过去几周,这类发现接连公开。9月30日,AI工程师Carter Church在X上发帖,说用GPT-6 Astra读懂了一封217年来无人能解的拿破仑军队密信,帖子浏览量超过538万。 10月1日,历史学家Benjamin Breen公开了用Opus 5.5智能体找到的1615年渡渡鸟捕猎记录。 一周后,Waites关于陨石的文章在Hacker News上获得184分。

Waites的流程是这样的:先给旧文献建立可按语义检索的索引(嵌入向量),大范围筛出候选段落,再用便宜的模型过滤,最后由大模型阅读、翻译,并与原始扫描件对照。 Breen则让大模型给嵌入检索挑出的候选排序,再亲自审阅这份清单。 提出问题、判断什么才算新发现,两人都是亲自完成的。

Reference 01波士顿的软件工程师Jesse Waites · 个人博客。Waites发布的Antiquity介绍文章附有JTPCK的说明,这家公司承接定制AI文档分析业务,并把这项工作列为自己的案例。Waites与JTPCK是什么关系,目前没有公开。

用一块GPU一夜索引东印度公司435万页档案,再翻查旧报纸,找到了目录中没有的陨石坠落、犀牛和火山喷发记录

Waites读了Breen那篇关于渡渡鸟的文章,心想"I can do this(我也能做)"。于是先问Deep Research助手,哪些历史问题可能用网上现有的资料解决,得到了13个候选。接着和Claude Code一起搭了一条流水线:用嵌入向量建索引,按语义检索,用小型判定模型Jev过滤,由Claude Haiku翻译并提取日期和地点,再由Claude Code智能体对照原始扫描件,最后与学界整理的陨石和火山目录比对。

荷兰东印度公司档案435万页、570万个段落,在一块GPU上通宵跑了12小时完成索引。Waites算过:按一个人每天读8小时、每周5天、每页2分钟计算,这些内容大约要读70年。过滤这一步也很便宜。一次查找动物记录的检索命中了59,000条提到大象的段落,交给Jev阅读过滤只花了约3美元。 据JTPCK的案例介绍页面,寻找陨石时用的是'a heavy stone fell from the sky with a loud report(一块沉重的石头伴着巨响从天而降)'这样的句子来检索。

正式开始之前,先让系统重新找出已知事件。看Breen的渡渡鸟记录、1783年Laki火山喷发、1815年Tambora火山喷发能否被检索出来,以确认检索是否正常。

结果有三项。第一项是开头那张版面上的1812年陨石坠落记录。这条记录不是来自东印度公司档案,而是来自旧报纸。Waites在翻查东印度公司档案的同时也搜索了旧报纸文章,陨石报道就刊登在其中的Java Government Gazette上。原版面可以在荷兰皇家图书馆的旧报纸阅览服务Delpher上查看。 这次坠落不在6份陨石目录中;如果得到确认,它将比Cokurrgaum所在的印度马哈拉施特拉邦此前最早的陨石坠落记录早26年。

第二项是1738至1740年作为礼物送给斯里兰卡康提国王的三头爪哇犀。1738年送出一头,1740年由Loverendaal号送出两头,但都在抵达前死去。Waites核对过的犀牛记录清单里都没有这批运送记录。第三项是火山喷发。对769条喷发报告进行过滤后,剩下3次史密森学会火山目录中没有的喷发:1722年2月的Gamkonora、1712年初的Ciremai、1780年2月的Slamet。犀牛和火山记录的原件是荷兰国家档案馆收藏的东印度公司档案。

这三项结果都还是未经专家审查的候选。Waites已联系陨石馆藏研究员、犀牛研究者Kees Rookmaaker和火山学家,正在等待回复。Waites还试图找出1808至1809年那次至今不知出自哪座火山的大喷发,但让智能体读完巴达维亚(今雅加达)第一份报纸上的全部633篇文章后,仍没有找到相关记录。

Waites发给Deep Research助手的问题

which open historical questions are most likely to be solvable with data that already exists online?

Jev过滤动物提及时提出的问题

Is this a real animal? Is it wild? Where is it?

根据要找的对象调整这三个问题。它们被用来从数万条提及中只留下真实的记录。

Reference 02加州大学圣克鲁兹分校历史学副教授Benjamin Breen · Res Obscura(Substack)

正在写动物灭绝专著的历史学家让Opus 5.5智能体翻查东印度公司档案,在渡渡鸟目击年表空缺的1611至1616年间找到了一条1615年的捕猎记录

Breen在为一本动物灭绝专著准备渡渡鸟一章时,让Opus 5.5智能体翻查GLOBALISE的东印度公司档案。GLOBALISE是荷兰多家研究机构用AI转录东印度公司手写档案并免费公开的项目。 Breen同时也用了GPT-6。据Breen介绍,Opus 5.5这样的智能体会分出多个和自己一样的智能体,分头阅读多种语言的史料;给它API密钥,它还能自己运行嵌入检索。这次工作中,智能体最多增加到12个左右。

智能体找到的段落出自1615年4月Wapen van Amsterdam号的航海日志。船员记下他们在毛里求斯"caught many tortoises, dodos [dodeersen], and some geese and parrots(捉了许多陆龟和渡渡鸟,还有几只鹅和鹦鹉)"。原件是荷兰国家档案馆的东印度公司档案。此前渡渡鸟目击年表在1611至1616年间没有记录,Breen认为这段文字正好可以填补这一空缺,并写道"I do think that this is a publishable result(我确实认为这是可以发表的成果)"。 在评论区,Breen也表示,据其所知,1615年4月这段记录此前从未被报道过。

已知的记录也回到原件重新阅读。1638年文献中的'velthoenderen'(看来是毛里求斯红秧鸡),在1890年一位法国学者的译本中被译成了'perdrix'(山鹑);Opus 5.5回到原始手稿,纠正了这处翻译。 无论是1615年的段落还是这处翻译更正,都还没有经过该领域专家的正式审查。

Reference 03SentinelOne的AI工程师Carter Church · 个人网站

一张扫描件交给GPT-6 Astra跑了约6小时,217年来无人能解的拿破仑军队密信被读懂了

这个案例不是翻查成堆的文献,而是读懂一份无人能读的文献。Church把1969年刊登在一份法国军事学术期刊上、写给Marmont将军的密信扫描件交给GPT-6 Astra,运行了约6小时。智能体只凭这一张扫描件,从转录字符一直做到破译。Church写道:"I spent six hours of model time and a few evenings of my own(用了模型的6小时,加上我自己的几个晚上)"。

这封信由1,300个密码单元组成,用到155种符号。此前公开的符号含义只有33个,靠它们能读出的只有1,300个单元中的435个。其余约三分之二由智能体从信件本身推解出来。它读出了信件的法语和英语全文,还把1969年重刊本中写错的日期更正为1809年3月底。

Church还公开了包含解密密钥(key.tsv)、转录密文和验证脚本(verify.py、reproduce.py)的解答包,任何人都能重新运行验证。以色列媒体Calcalist报道,密码研究网站Cryptiana的运营者Satoshi Tomokiyo已将这份密码标记为"已解决"。

用过的人怎么说

好评

  • “The agents doing the grunt reading while you decide what matters feels like the actual division of labor.”

    智能体承担繁重的阅读,人来决定什么重要,这才像真正的分工。

    Rohan Jaiswal · Breen文章评论resobscura.substack.com
  • “For every amount of pages you have the time to read, an LLM provides a means to filter the set of pages you choose to read to a set that is more likely to be useful. It does not need to be perfect at it”

    有时间读多少页,LLM就能把要读的页面筛成更可能有用的那一批,而且不需要做到完美。

    vidarh · Hacker Newsnews.ycombinator.com
  • “As an AI "hater", I definitely think there are very useful and net-positive (and underrated yet) applications of the LLM technology. Finding something in archives is definitely one of those.”

    自称AI"黑粉",但认为在档案中查找资料无疑是很有用、且仍被低估的用途。

    sedan_baklazhan · Hacker Newsnews.ycombinator.com
  • “these kind of things are inspiring – especially if you are getting more confidence in that Mauritius-to-India link.”

    《纽约时报》视觉调查报道团队的记者。认为这类工作很有启发,尤其是如果对毛里求斯与印度之间的联系更有把握的话。Breen在文中讨论了一个假说:毛里求斯的渡渡鸟可能被带到了印度莫卧儿皇帝贾汉吉尔的宫廷。

    Christiaan Triebert · Breen文章评论resobscura.substack.com

不足之处

  • “"Ree" refers here to a "r(e)ede": a safe place for large ships to anchor (so not a road).”

    荷兰历史考古学家。Breen文章中的AI译文把航海记录里的荷兰语'Ree'译成了道路(road),这条评论指出,这个词指的是大船可以安全下锚的锚地。

    Zachariah Hopkins · Breen文章评论resobscura.substack.com
  • “AI models can be confidently wrong”

    AI模型可能会自信满满地出错。模型曾把落在爪哇的火山灰归到1,500公里外的一座火山头上。

    Jesse Waites · 本人文章jessewaites.com
  • “Opus 5.5 and GPT-6 ended up spawning up to a dozen independent agents that that drilled down into minutiae and got utterly lost in the weeds.”

    智能体增加到12个左右,钻进琐碎细节,彻底迷失了方向。文中还写道,提出合适的问题、判断发现的意义,这些AI目前还做不到。

    Benjamin Breen · 本人文章resobscura.substack.com
  • “But I'm not sure amateur sleuths will be able to do anything relevant.”

    过去半年用LLM给100多万页手稿分类的历史学家。即便如此,也不确定业余爱好者能否做出有意义的成果。

    Thiago Krause · Breen文章评论resobscura.substack.com

如何开始

这套流程里没有只适用于古文献的步骤。只要有多到读不完的文档和一个问题,比如公司内部会议记录或客户咨询记录,就可以照着做:先用已知答案的事来检验检索,再大范围筛选,用便宜的模型过滤,最后把大模型读过的内容与原件核对。Waites也是用同样的方法翻查东印度公司档案和旧报纸版面的。

练手的材料可以用GLOBALISE免费公开的东印度公司档案。该项目正用AI转录500多万页手写文献,可通过网页阅览器浏览,也可在Dataverse下载数据集。

打开用Antiquity建好的工作文件夹,智能体会按照Antiquity写好的7个步骤推进:提出问题,同时挑出一个已知答案的事件作为检验检索的对照组(Antiquity称之为"预先埋下的手表");用嵌入检索大范围召回;用便宜的模型过滤;用大模型细读;与原始页面核对;确认学界整理的记录清单中是否已有;保存证据,整理成文。

  1. 1

    安装Antiquity

    免费开源。检索和模型调用由打开该文件夹的编程智能体完成,所以模型费用另计。

    安装命令

    go install github.com/jessewaites/antiquity@latest

  2. 2

    用自己的问题创建工作文件夹

    它会询问名称、一句话问题、详细说明和API密钥(可选)四项,然后创建一个包含AGENTS.md、CASE.md、HANDOFF.md等文件的文件夹。

    创建文件夹

    antiquity new my-investigation

  3. 3

    在该文件夹中打开编程智能体

    进入文件夹,打开Claude Code或Codex。

    进入文件夹

    cd my-investigation

  4. 4

    先让它重新找出已知事件

    这一步用来确认检索是否正常。Waites先看了渡渡鸟记录、1783年Laki喷发和1815年Tambora喷发能否被找出来。

需要准备

  • Go(运行安装命令go install时需要)
  • Claude Code或Codex等编程智能体
  • 模型API费用,以及运行嵌入索引的GPU(Antiquity是工作文件夹工具,本身不做检索,也不调用模型)

分享此参考

每周一期 · 免费

这篇参考对你有帮助吗?

每周海量 AI 资讯里的 BEST
只挑 3 条,直接送到你的邮箱

Work Smarter with AI

420 人每周都在读

订阅成功 下一期起,我们在你的邮箱见。