搜索表现不错,但一问 AI,我们公司就消失了
核心关键词位居 Google 前列,内容也在持续发布。但当潜在客户请 ChatGPT 或 Perplexity 推荐产品时,出现的可能只有竞争对手。对营销团队来说,很难判断应该先修复什么。因为无法在同一屏幕中看清:是页面问题、搜索爬虫被拦截,还是 AI 选中了来源却没有将其用于回答。
AEO 自动化首先要解决的不是制造推荐,而是反复观察这些空白。 在相同执行环境中定期输入相同问题,并分别记录搜索访问、用户请求型访问、来源选择、答案吸收和点击流量,才能选择需要修改的页面。
Google 排名与 AI 推荐不是同一张成绩单
即使搜索排名很高,也不代表一定会被纳入生成式搜索的回答。审视近期 GEO 研究的一项综述将曝光过程描述为一条概率性管线,依次涵盖抓取、检索、重排序、引用、答案吸收和用户行为。一个阶段的成功不能视为下一个阶段的成功,而具有长期效果、且适用于多个平台的优化成效,尚未得到充分证实。
尤其需要注意的是,被选为来源与品牌被有意义地吸收到答案中并不相同。 一项预印本研究在三个平台分析了 602 个提示词,基于 21,143 条有效引用,分别衡量了引用覆盖范围和答案吸收深度。 这一分数是答案吸收的代理指标,而不是营收,但它提供了一项判断依据:只统计引用次数可能会错过实际可见性。
请将 AEO 基线分为五个栏位。
- 搜索访问:搜索机器人在配置上是否获准,以及是否观察到实际请求日志
- 用户请求型访问:由用户请求获取页面的代理是否出现在服务器日志中
- 来源选择:回答的来源中是否显示自家 URL
- 答案吸收:自家的主张、数据或产品特性是否实际用于回答
- 行为:用户是否点击链接并访问网站
如果只检查了 robots.txt 或 WAF 规则,请不要记录为“已确认访问”,而应记录为“配置上允许”。只有在服务器或 WAF 日志中确认到相应请求和 HTTP 响应时,才单独标记实际访问。
自动化负责观察和草稿,人负责批准变更
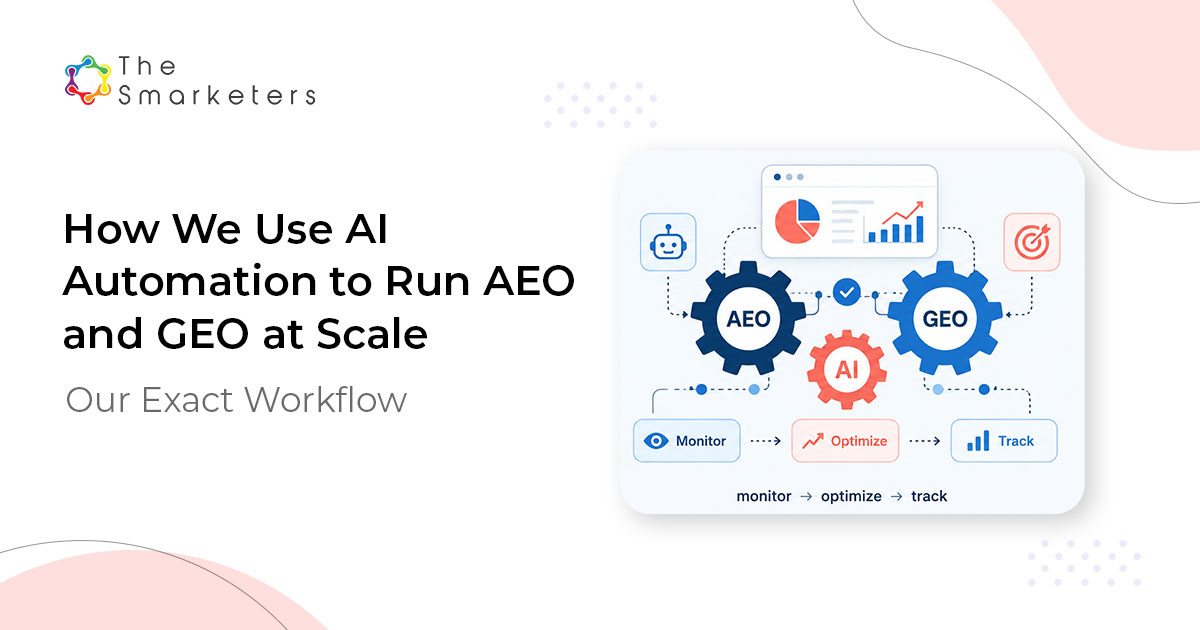
AGENDA 原文公开的方法是一个五步循环:重复进行监控、差距分析、内容优化、标记部署和结果跟踪。它在多个 AI 平台运行固定的买家问题并保存结果,再生成分析与修改草稿,由人工审核准确性、优先级和品牌文风后再部署。
该案例并非公开了客户样本、对照组或营收效果的绩效研究。因此,自动化可验证的价值并不在于“将引用率提升百分之几”,而在于让分散的检查能以相同的问题和相同的记录格式重复进行。
| 工作 | 适合自动化的部分 | 由人决定的部分 |
|---|---|---|
| 问题检查 | 运行固定问题,保存执行条件和回答 | 选择反映真实购买情境的问题 |
| 差距分析 | 汇总自家及竞品提及和来源 URL | 判断错误说明和重要遗漏的优先级 |
| 内容修改 | 生成答案结构和标记草稿 | 审核事实、用户价值和品牌文风 |
| 部署与跟踪 | 记录检查结果和下一次运行结果 | 批准部署并解读结果 |
第一个基线从 5 个问题和一张执行环境表开始
先确定要使用的面向消费者产品界面。例如,在 ChatGPT、Claude、Perplexity 中选择团队实际要检查的界面,并确认相关账户或组织的访问权限以及网页搜索功能是否可用。还要准备 5~10 个近期客户或销售团队实际使用过的品类问题、自家名称和竞品名称,以及记录结果的电子表格。
回答可能会因登录状态、地区、模型或产品名称以及是否启用搜索功能而不同。因此,在输入问题前记录这些条件,并在下次检查时尽可能保持一致。不要假设通过 API 自动运行的结果与面向消费者的界面行为相同;应将其作为单独面板管理。
- 先固定各平台的执行条件。
在表中填写平台和产品界面、模型或产品名称、是否登录、账户或组织、执行地区、是否启用网页搜索以及执行日期。无法确认条件的项目不要猜测,应标记为“无法确认”。 - 分别检查搜索机器人与用户请求型代理。
OpenAI 区分用于搜索曝光的 OAI-SearchBot、用于训练的 GPTBot,以及用户请求型的 ChatGPT-User。 Anthropic 也分别说明了 Claude-SearchBot、ClaudeBot 和 Claude-User,Perplexity 则区分 PerplexityBot 与 Perplexity-User。 在 robots.txt 中检查搜索机器人规则后,将 OpenAI 和 Perplexity 文档所链接的最新官方 IP 范围与 WAF 的允许、拦截规则进行比对。在服务器或 WAF 日志中,应同时检查用户代理、提供官方范围时的请求 IP、请求 URL、时间和 HTTP 响应状态。将搜索机器人和用户请求型代理的结果记录在不同列中。如果没有日志,不要判定为实际访问,应保留为“配置上允许”或“未观察到”。 - 按购买阶段写下固定问题和措辞变体。
例如,写成“拥有 200 名员工的 B2B SaaS 公司在管理韩语客户案例时,适合使用什么内容平台?”这样可清楚体现对象、情境和选择标准。同时登记语义相同的变体,例如“请比较用于制作韩语 B2B 客户案例的工具”。 - 在选定的面向消费者界面运行问题,并保留原始结果。
在每个界面输入相同问题后,保存完整回答或快照以及显示的来源 URL。结果表中应分别建立平台、执行条件、执行日期、问题原文、自家提及、竞品提及、来源 URL、答案中吸收的主张和说明错误等列。还要单独判断:是否只是附上了来源链接,以及该页面内容是否实际被用作比较或推荐依据。 - 从错误和遗漏中选择修改候选页面。
如果产品说明有误,或在重要购买问题中没有选中合适的自家页面,就将该页面列为候选。AI 生成的修改方案和标记,应先由编辑审核事实、文风和对用户的实用性,再进行部署。 - 使用相同条件和问题面板再次运行。
下次检查时也要对齐面向消费者界面、执行条件、问题和记录列,以比较品牌提及、来源选择、说明准确性和答案吸收有何变化。如果条件发生变化,应记录变更内容,不要与同一系列结果简单合并。由于平台回答具有波动性,也不应将一次出现当作固定排名来报告。
平台 / 产品界面 / 模型: ______
登录·组织 / 地区 / 搜索启用状态: ______
问题 / 措辞变体: ______
执行日期 / 完整回答·快照位置: ______
搜索机器人: 配置上允许·拦截 / 日志观察 / HTTP 状态: ______
用户请求型访问: 日志观察 / HTTP 状态: ______
自家·竞品提及: ______
显示的来源 URL: ______
答案中吸收的主张: ______
说明错误和修改候选: ______
第一个交付物不是引用率提升报告。 只要有一张填满所有问题与平台组合的执行条件和回答的基线表、一份不夸大访问状态的日志检查表,以及优先修改页面的清单,就足够了。
查看 GA4 流量,但也要记住看不见的曝光
在 GA4 中,来自已识别的 ChatGPT、Gemini、Copilot 等服务的访问,会被归类到默认渠道组中的AI Assistant。无需另建正则表达式,也可在 Acquisition 报告中查看该渠道的会话。但来自 Google AI Overviews 和 AI Mode 的访问不会归入 AI Assistant,而是归入 Organic Search。
GA4 显示的只是点击链接后产生的访问。品牌出现在回答中但用户没有点击,或显示为来源却没有带来访问的情况,都无法捕捉。因此,需要将 AI Assistant 会话与前面建立的提及、来源和答案吸收记录一起查看。
结构化数据也应遵循相同原则。Google 明确指出,正确编写的结构化数据并不保证会在搜索结果中显示。 更重要的是,该文档是 Google 的富媒体搜索结果政策,不是其他 AI 平台的引用保证书。记录标记检查通过即可,但实际答案变化应通过固定问题面板另行确认。
如果想进一步深入
Overview of OpenAI Crawlers 用于区分 ChatGPT 搜索机器人、模型训练机器人、用户请求型代理及官方 IP 范围的官方文档。 developers.openai.com
Perplexity Crawlers 可了解搜索用 PerplexityBot 与用户请求型 Perplexity-User 的区别,以及需在 WAF 中检查的官方 IP 范围。 docs.perplexity.ai
From Citation Selection to Citation Absorption 可结合研究设计了解为何应分别衡量来源选择与实际答案吸收。 arxiv.org
Default channel group 可确认 GA4 的 AI Assistant 分类和 Google AI 搜索流量例外的官方文档。 support.google.com