Loading...

判断模型 · Jev

不写文章、只做判断的 AI 模型 Jev:500 封邮件 25 秒分完,只花了 3.5 美分

Jev 不写文字,专做判断:从选项里挑一个,或者回答是与否,所以又快又便宜。我们收集了四个人交给它的活:清理邮箱、整理截图文件夹、给一个品牌的 1,891 条广告分类,还有一家媒体的评估负责人拿它检查文章的「AI 味」。

2026年9月30日·4 个案例

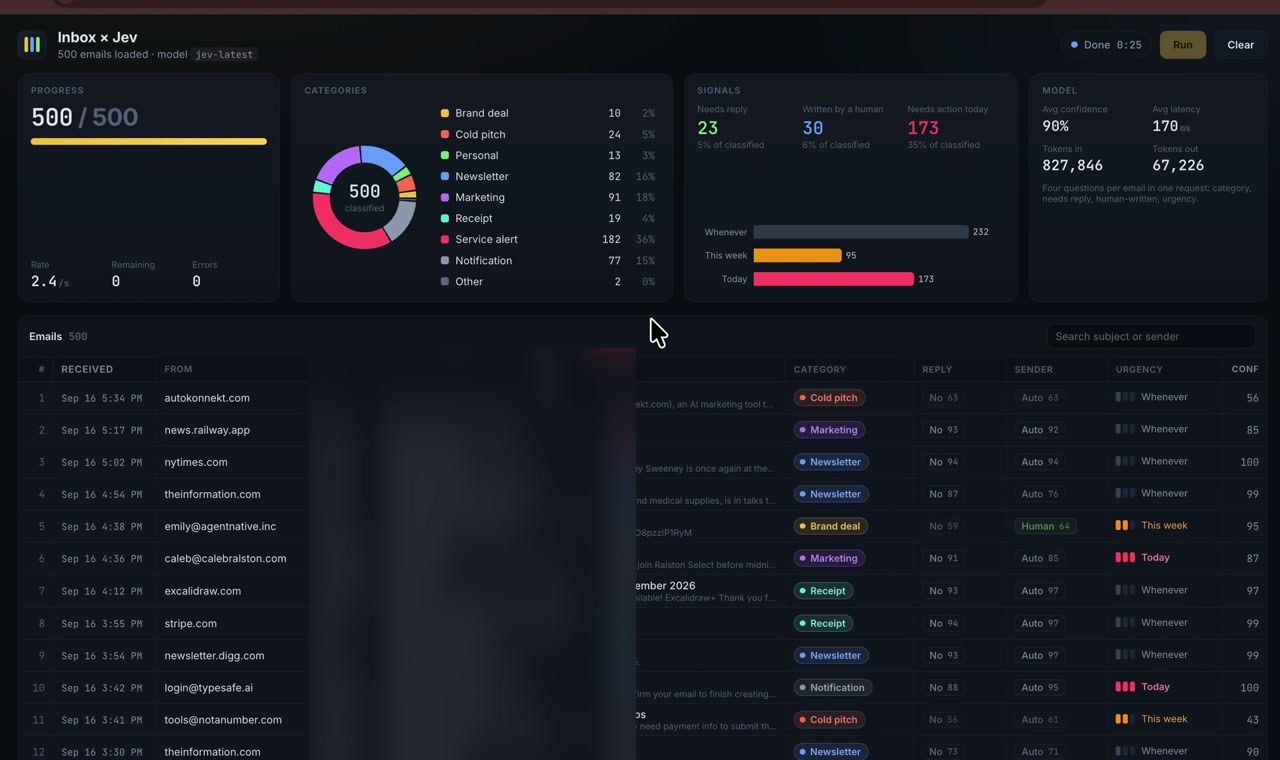
Inbox × Jev 界面:500 封邮件 25 秒分完,显示各类别的数量、需要回复的 23 封邮件和紧急程度
Riley Brown 做的 Inbox × Jev 界面。500 封邮件 25 秒就分好了。邮件标题和预览做了模糊处理。

交给 AI 的活里,有不少其实不是写作,而是判断:这封邮件要不要回?这条广告瞄准的是哪类客户?这张截图该放进哪个文件夹?可这类判断交给 ChatGPT、Claude 这样的模型,它们要把答案写成一段话,一条就得花几秒到几十秒;跑上几千条,费用也很快涨上去。

9 月 15 日 TypeSafe 推出的 Jev 干脆不写字。它只从设定好的选项里挑一个、回答是或否、或者打分,同时用概率告诉你它对这个答案有多大把握。 价格是每 100 万输入 token 0.042 美元,返回的答案不收费。

它的作者 Diogo Almeida 是 InstructGPT 论文的共同作者,ChatGPT 正是在这篇论文的基础上做出来的。 他在 X 上的发布帖浏览量超过 3,980 万,三天之内,Vercel、Cloudflare、OpenRouter 都在自家服务里接入了 Jev。 9 月 20 日取消候补名单后注册量猛涨,两天后就暂停了新用户注册,9 月 27 日又重新开放。 9 月 29 日,OpenAI 也推出了做同一件事的 Decisions API 预览版:从设定好的答案里挑一个,不光能接收文字,也能接收图片。

有了又便宜又快的判断,大家最先丢给 Jev 的,是那些一直堆着没处理的东西:邮箱、截图文件夹、广告库,还有过去写的文章。
Reference 01创作者 Riley Brown · 自己的邮箱

500 封邮件一次问四个问题,25 秒挑出 23 封需要回复的

Riley Brown 把自己邮箱里的 500 封邮件导进一个自己做的界面,交给 Jev。每封邮件只发一次请求,同时问四件事:属于哪类邮件、需不需要回复、是不是人亲手写的、有多紧急。

界面上的计时器停在 25 秒。500 封邮件被分成服务通知、营销、Newsletter 等九类,判断为需要回复的有 23 封,人写的邮件有 30 封。他公布的成本是 3.5 美分,还在回复里补充说,1,000 次请求花了 7 美分。

界面上写明的提问方式

Inbox × Jev · 2026-09-17

Four questions per email in one request: category, needs reply, human-written, urgency.

每封邮件发一次请求,问四件事:类别、是否需要回复、是否由人写的、紧急程度。

Reference 02Cloudflare 开发者教育负责人 Fayaz Ahmed · 自己的截图文件夹

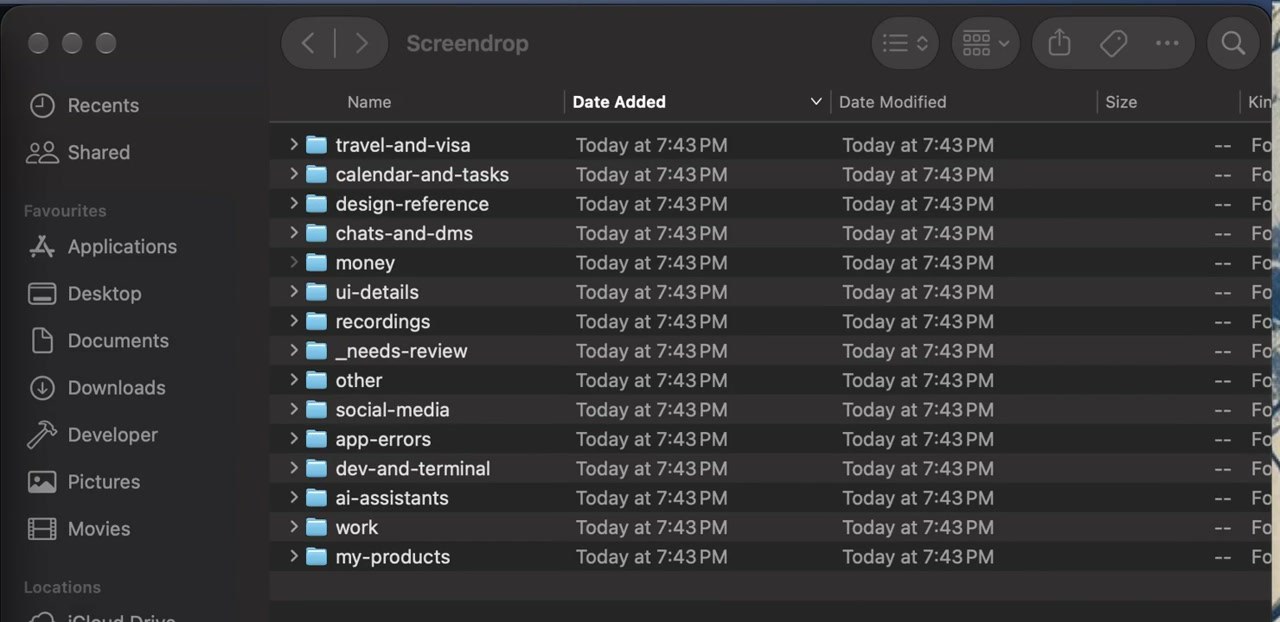
几个月攒下的 970 张截图,40 秒分进旅行、工作、付款等 15 个文件夹

Fayaz Ahmed 的 Mac 里,截图应用几个月来存下了 970 张截图。他先用 Mac 自带的文字识别把图里的文字提出来,再让 Jev 读这些文字、挑文件夹。Jev 不看图,只看文字。

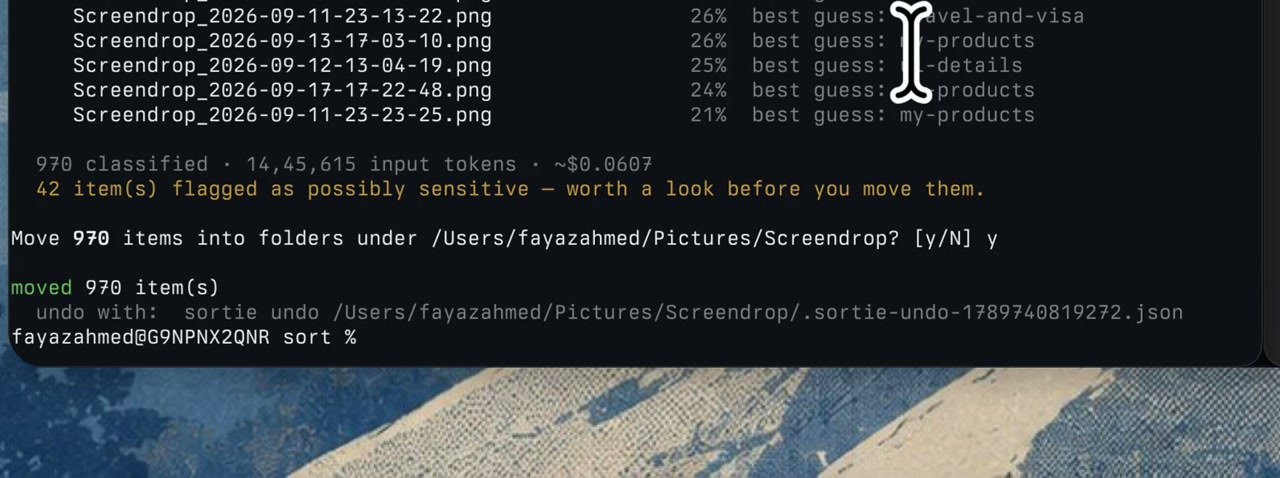
分类花了 40 秒左右,成本约 6 美分。移动文件前会先请他确认,看起来敏感的 42 张截图被单独标了出来。移完之后,还留下一条可以一次撤回的命令。

Finder 界面:Screendrop 文件夹里新建了 travel-and-visa、calendar-and-tasks、money、work 等 15 个文件夹
分类完成后新建的 15 个文件夹。来源:Fayaz Ahmed,X(2026-09-18)
终端界面:970 张已分类,成本约 0.0607 美元,可能敏感的项目 42 个,还有移动前的确认和撤回命令
970 张分类完毕,约 0.06 美元,42 个可能敏感的项目,外加撤回命令。把握不高的文件旁边标着推测概率。

Reference 03营销 AI 工具 Maxfusion 的 Stav Zilbershtein · 自家工具演示

一个品牌在投的 1,891 条广告,19 秒按用户旅程阶段分好

Stav 把 Resilia 这个品牌放在广告库里的 1,891 条广告交给 Jev,问每条广告瞄准的是用户旅程五个阶段里的哪一个、属于哪种广告形式。五个阶段从还没意识到问题的人,一直到准备下单的人。广告图片先由 Gemini 转成文字描述,Jev 再读这些文字做选择。

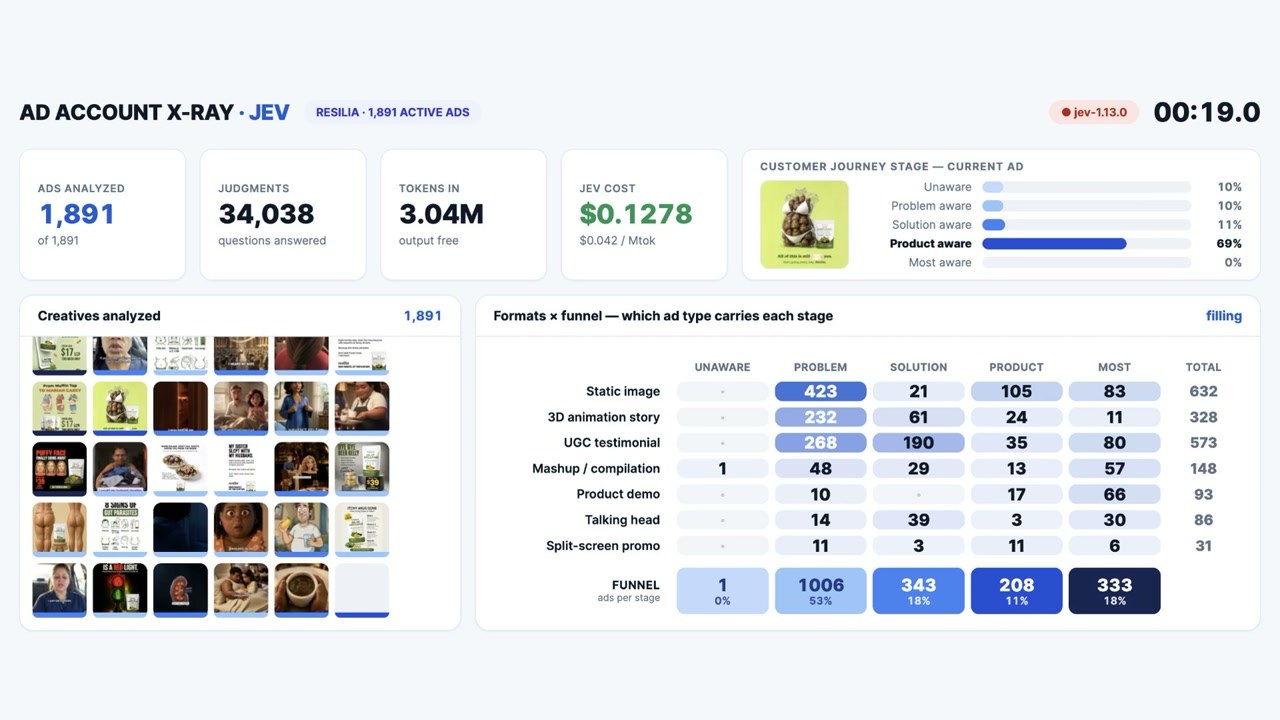
19 秒内出了 34,038 个判断,成本 13 美分。超过一半的广告,也就是 1,006 条,瞄准的是已经意识到问题的人;瞄准准备下单人群的广告有 333 条。Stav 表示,打算把这个功能放进自家公司的工具里。

AD ACCOUNT X-RAY 界面:1,891 条广告,34,038 个判断,成本 0.1278 美元,用时 19 秒。广告形式与用户旅程阶段交叉的表格
广告形式(纵向)与用户旅程阶段(横向)的交叉表。来源:Stav Zilbershtein,X(2026-09-18)

Reference 04美国媒体 Every 的评估负责人 Mike Taylor · 自己写的 27 篇文章

37 篇文章、21 个「AI 味」问题,0.7 秒给出 777 个判定

Every 是一家专讲怎么和 AI 一起工作的美国媒体,在 Jev 发布前一周就开始试用了。评估负责人 Mike Taylor 把自己写的 27 篇文章,加上 10 篇故意用 AI 文风写的文章,一起交给 Jev。问题有 21 个,选自 Every 平时用来揪出文章 AI 味的检查清单。777 个判定在 0.7 秒内全部出来,成本约 0.25 美分。

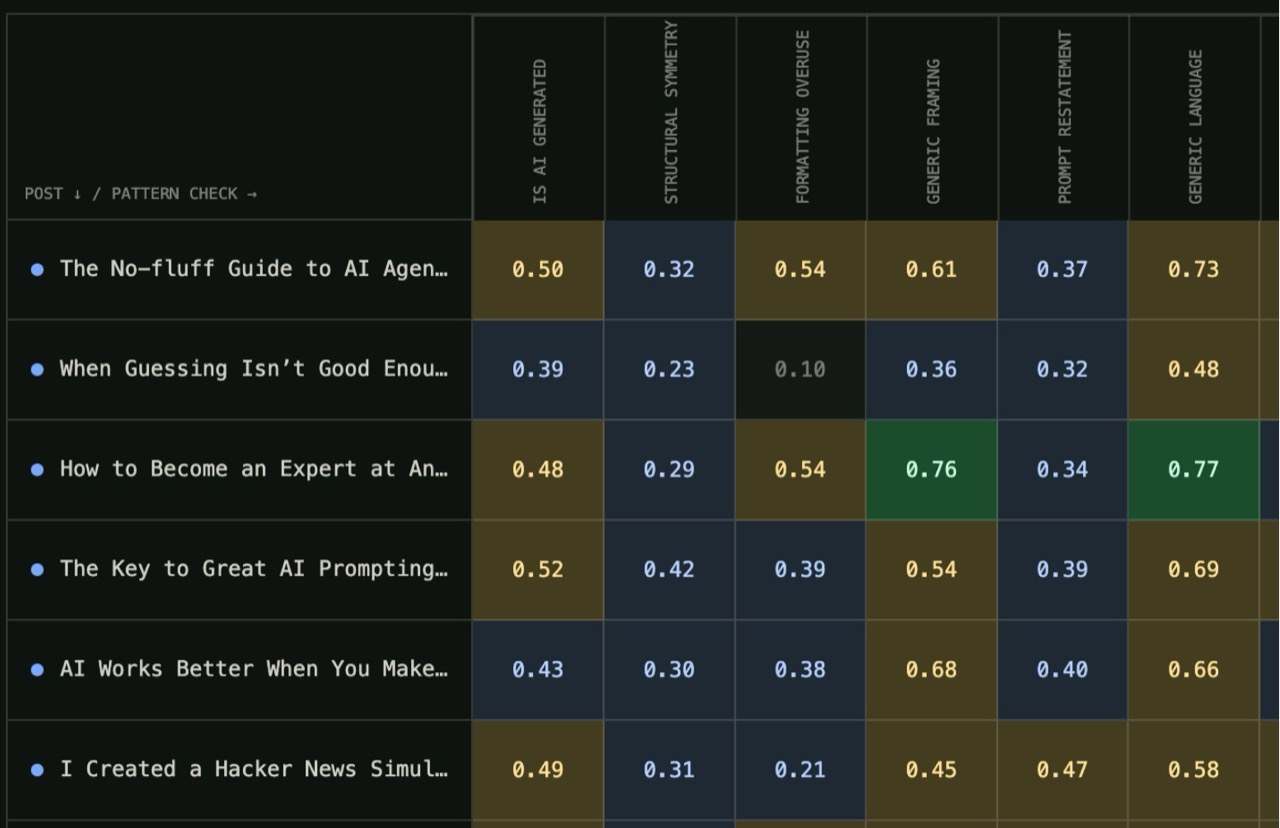
不过,把每种文风模式的分数取平均,这个办法行不通。Mike 自己的真实文章也用了打磨过的结构和修辞套路,平均分反而比 AI 文风的文章还高。 在 CEO Dan Shipper 另做的一次测试里,Jev 抓出了故意埋下的 7 处缺陷中的 6 处。同一测试里 Claude Fable 5.1 七处全中,但 Jev 快了约 25 倍,成本只有它的约 1/580。

Mike 写道,真正投入使用前,他还想再确认准确度;但比起完全不检查,拿它当最先响起的警报已经够用。

表格:行是文章标题,列是 IS AI GENERATED、STRUCTURAL SYMMETRY 等 AI 文风模式,每格填着 0 到 1 之间的概率
行是文章,列是 AI 文风模式。越接近 1,说明 Jev 越觉得有 AI 味。来源:Every(截图由 Mike Taylor 提供)
Every 提的 21 个问题中的 5 个
  1. 1Does this writing appear likely to have been generated primarily by an AI? Judge only the text, not its topic or author metadata.
  2. 2Does the writing rely on generic framing instead of concrete context?
  3. 3Does the writing explain straightforward points more than necessary?
  4. 4Does the writing repeat the same idea without adding new evidence?
  5. 5Does the writing end with a generic offer to help or continue?

21 个问题的完整版在 Every 的实验网站上。

用过的人怎么说

速度和价格几乎一边倒地受到称赞,准确度则众说纷纭。有人说,在选项清楚的分类任务上,它和小型 LLM 差不多甚至更好;但更多人说,在需要细微分辨的判断或安全相关的判断上,它不如 Haiku 和 Gemini。对于「回答 0.8 就有 80% 会对」这种概率说法,也冒出了不少反例。最常见的结论是:把 Jev 当第一道筛子,拿不准的交给大模型或人。

官网写的是快 193.6 倍、便宜 444.6 倍;但把发布后四天里用户在 X 上贴出的数字汇总起来,速度的中位数是快 7 倍,价格是便宜 30 倍。

好评

  • “Probably around 750,000 classification problems, cost 26 cents and it did great job.”

    给一个菜谱合集打标签,约 75 万次分类花了 26 美分,结果也很好。

    u/natlight · Redditreddit.com
  • “737 predictions had ≥99% confidence. Every one matched the reference label. Below 70% confidence, nearly half were wrong.”

    把握在 99% 以上的 737 条全部判对,低于 70% 的将近一半判错。他说,拿它来挑出需要人工复核的条目很好用。

    Nikhil Mudholkar(Bryo CTO)· Xx.com
  • “On Korean medical questions, taking only its most confident half cuts the error rate from 20% to 2%.”

    在韩国医师国考题上,只采纳把握最高的那一半,错误率从 20% 降到 2%。

    MahlerLab · 医疗数据研究者ahn-lab.org
  • “Claude, codex 등 플러그인으로 사용해 봤는데 검증 결과가 나오는 속도가 장난 아닙니다.”

    当作 Claude、Codex 等工具的插件用了一下,出验证结果的速度快得离谱。

    @parktaegyun · YouTube 评论youtube.com

不足之处

  • “Jev's own verdict loses clearly on accuracy (McNemar p < 0.0001) and wins on speed and cost.”

    在 2,000 封钓鱼邮件上,Jev 判对 62.6%,Haiku 判对 81.3%,而两行的正则表达式规则是 91.6%。

    anisselbd · GitHubgithub.com
  • “Jev always chose face 1 and the probability it returned was about 83%”

    让它掷一个公平的骰子,问了 400 次,它每次都选 1,给出的概率大约是 83%。

    kantahayashi · Hacker Newsnews.ycombinator.com
  • “Jev's median call was 6.3× faster than Sonnet's. Fast, but not 40–200×.”

    比 Sonnet 快 6.3 倍。快是快,但不是官方说的 40~200 倍。

    dchristopoulos · Hacker Newsnews.ycombinator.com
  • “0.9 이상이면 확실하다고 판단해도 될 줄 알았다. 그런데 애매한 task에 오히려 높은 confidence가 찍히는 경우가 나왔다.”

    原以为 0.9 以上就可以当作确定,结果模糊的任务反而打出了很高的 confidence。作者写道,问题不在 Jev,而在自己设计选项时让边界互相重叠了。

    「巧克力曲奇的练习本」· Tistoryjjeongil.tistory.com

怎么开始

  1. 1

    在 TypeSafe 控制台注册账号

    9 月 27 日重新开放注册,从这时起新用户不再送免费额度。如果你已经在用 OpenRouter 或 Vercel AI Gateway,也可以直接在那里调用。

    console.typesafe.ai ↗
  2. 2

    在 Playground 里先试一个问题

    随便贴一段文字,再配一个是非题,答案和概率马上就出来。官方文档里的示例问题是这个。

    官方示例问题

    Does this message express urgency?

  3. 3

    给你在用的 AI agent 装上官方 skill

    在 Claude Code、Codex、Cursor 这类 agent 里装好 skill,agent 就会替你写调用 Jev 的代码。

    安装

    npx skills add typesafe-ai/skills --skill typesafe-ai

  4. 4

    用一句话说清要它判断什么

    这是 skill 仓库里给的示例请求,连「拿不准的交给人看」这个条件都写进去了。

    官方示例请求

    Use TypeSafe to route incoming support tickets by department, with human review for uncertain decisions.

  5. 5

    中文内容先拿几十条试准

    官方文档说明,它主要用英文训练,韩文、日文、中文达不到同样的水平。数字计算和日期比较也被列为弱项,文档建议这类判断交给代码去做。

需要准备

  • TypeSafe、OpenRouter、Vercel AI Gateway 任一处的 API key
  • 要判断的文字(邮件、咨询、文件里的文字等文本)
  • 用 skill 接入时,还需要你在用的 AI agent

分享此参考

这个参考对您有帮助吗?

每周精选参考直达您的邮箱