Loading...

판정 모델 · Jev

글은 쓰지 않지만 판단은 빠른 AI Jev, 메일 500통을 25초 만에 3.5센트로 분류했어요

Jev는 글을 쓰는 대신, 보기 중 하나를 고르거나 예·아니오를 답하는 판단에 집중한 모델이에요. 그래서 빠르고 싸요. 메일함, 스크린샷 폴더, 한 브랜드의 광고 1,891개, 매체 평가 책임자의 'AI 티' 점검까지 네 사람이 맡긴 일을 모았어요.

2026.09.30·사례 4

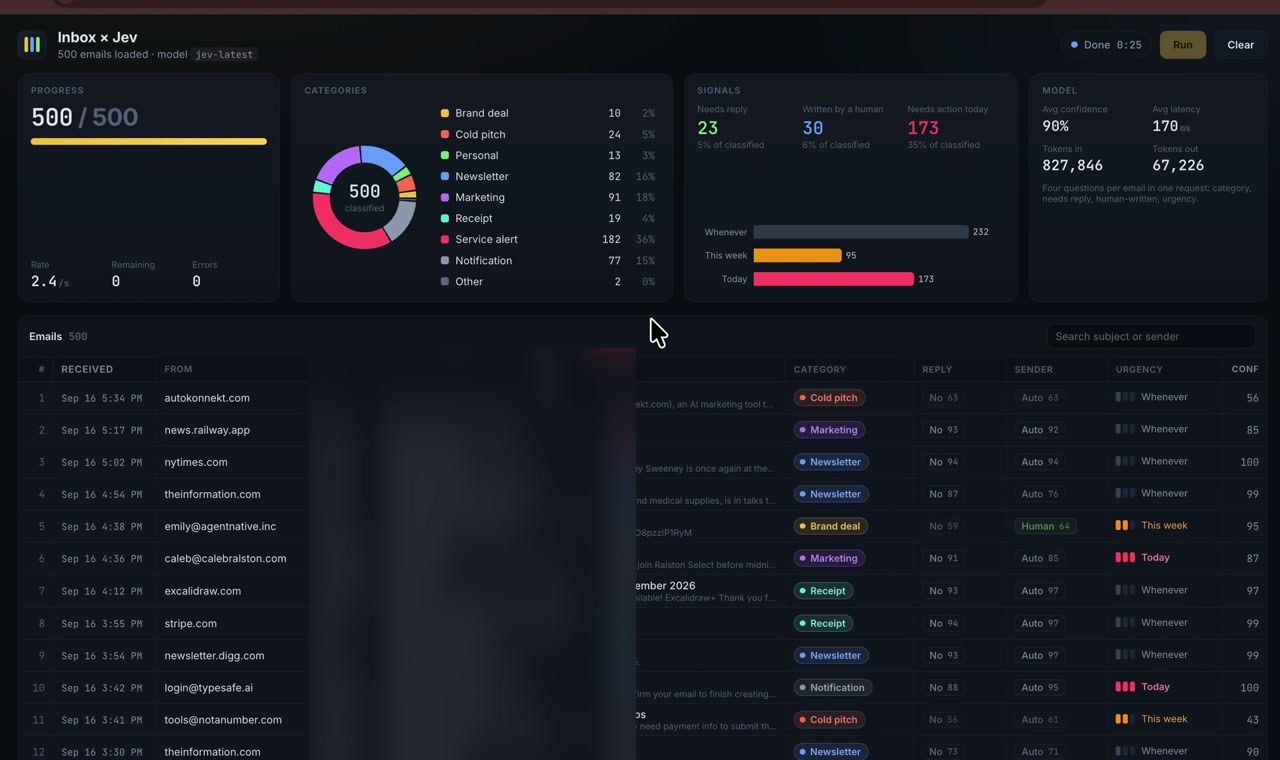
Inbox × Jev 화면. 메일 500통을 25초 만에 분류해, 종류별 개수와 답장이 필요한 메일 23통, 급한 정도가 나와 있다
Riley Brown이 만든 Inbox × Jev 화면. 메일 500통 분류가 25초에 끝났어요. 제목과 미리보기는 흐리게 처리돼 있어요.

AI에게 맡기는 일 가운데 꽤 많은 것이 사실은 글쓰기가 아니라 판단이에요. 이 메일에 답장이 필요한가, 이 광고는 어떤 고객을 노리나, 이 캡처는 어느 폴더로 가야 하나. 그런데 이런 판단도 ChatGPT나 Claude 같은 모델에 맡기면 답을 글로 풀어 쓰느라 한 건에 몇 초에서 수십 초가 걸리고, 수천 건을 돌리면 값도 금세 불어나요.

9월 15일 TypeSafe가 내놓은 Jev는 글을 아예 쓰지 않아요. 정해 둔 보기 중 하나를 고르거나, 예·아니오를 답하거나, 점수를 매기고, 그 답을 얼마나 확신하는지 확률로 함께 돌려줘요. 값은 입력 100만 토큰에 0.042달러이고, 돌려주는 답에는 값을 받지 않아요.

만든 사람은 ChatGPT의 바탕이 된 InstructGPT 논문의 공동 저자 디오구 알메이다(Diogo Almeida)예요. 그의 출시 글은 X에서 조회 3,980만 회를 넘었고, 사흘 안에 Vercel·Cloudflare·OpenRouter가 자기 서비스에서 Jev를 부를 수 있게 붙였어요. 9월 20일 대기자 명단을 없앴다가 몰려든 가입 때문에 이틀 만에 신규 가입을 멈췄고, 9월 27일 다시 열었어요. 9월 29일에는 OpenAI가 같은 일을 하는 Decisions API를 미리보기로 내놓았어요. 정해 둔 답 가운데 하나를 고르는 API이고, 글뿐 아니라 이미지도 받아요.

싸고 빠른 판단이 생기자, 사람들이 먼저 Jev에 넣어 본 건 그동안 쌓여만 있던 것들이었어요. 메일함, 스크린샷 폴더, 광고 라이브러리, 지난 글이에요.
Reference 01크리에이터 라일리 브라운(Riley Brown) · 자기 메일함

메일 500통에 네 가지를 한 번에 묻자, 25초 만에 답장할 메일 23통이 추려졌어요

라일리 브라운은 자기 메일함의 메일 500통을 직접 만든 화면에 불러와 Jev에 맡겼어요. 메일마다 한 번의 요청으로 네 가지를 물었어요. 어떤 종류의 메일인지, 답장이 필요한지, 사람이 직접 썼는지, 얼마나 급한지예요.

화면의 타이머는 25초에 멈췄어요. 500통은 서비스 알림·마케팅·뉴스레터 같은 아홉 종류로 나뉘었고, 답장이 필요하다고 본 메일은 23통, 사람이 쓴 메일은 30통이었어요. 그가 밝힌 비용은 3.5센트였고, 답글에서는 요청 1,000건에 7센트가 들었다고 덧붙였어요.

화면에 적힌 질문 구성

Inbox × Jev · 2026-09-17

Four questions per email in one request: category, needs reply, human-written, urgency.

메일마다 한 번 요청해서 네 가지를 물어요. 종류, 답장이 필요한지, 사람이 썼는지, 얼마나 급한지.

Reference 02Cloudflare 개발자 교육 담당 파야즈 아메드(Fayaz Ahmed) · 자기 스크린샷 폴더

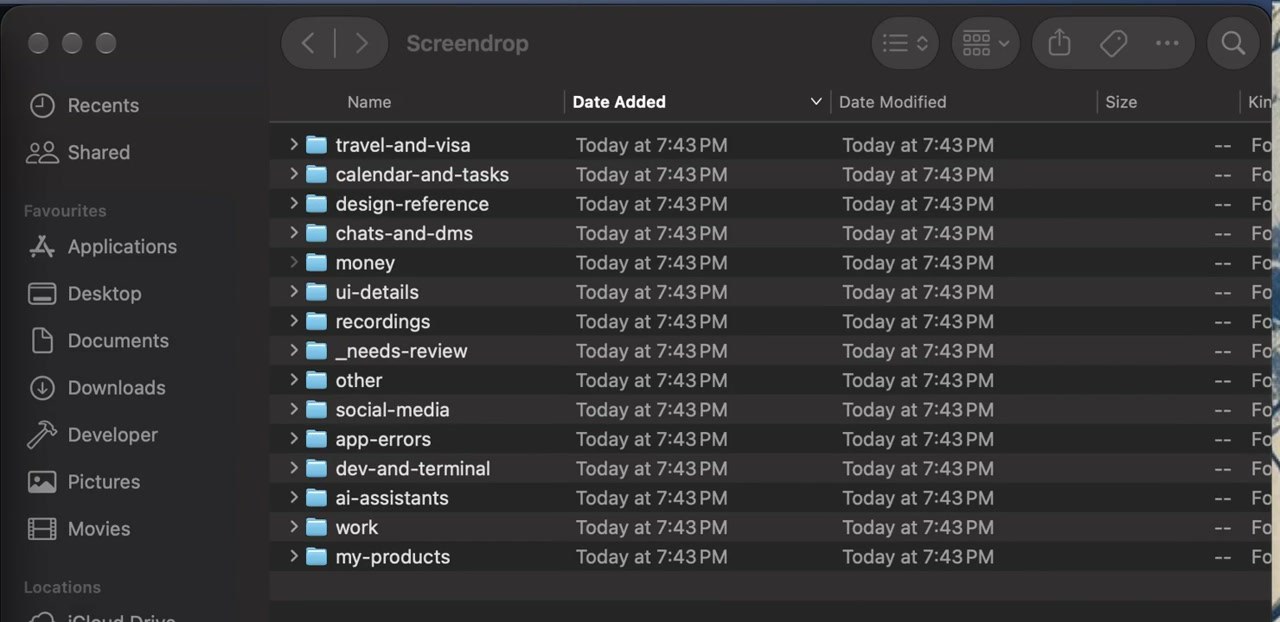
몇 달 치 스크린샷 970개가, 40초 만에 여행·업무·결제 같은 폴더 15개로 나뉘었어요

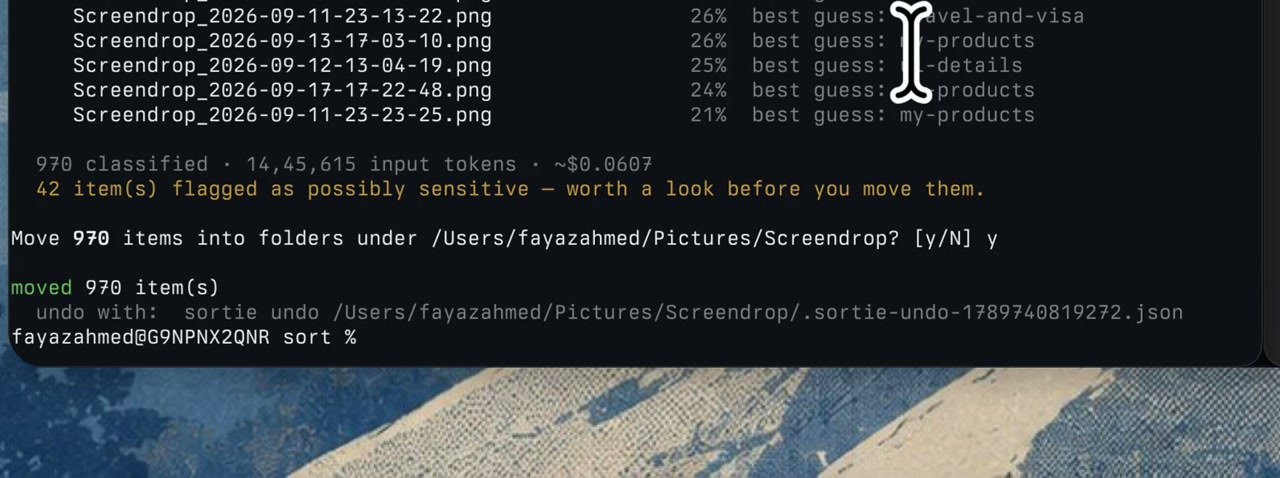
파야즈 아메드의 맥에는 스크린샷 앱이 몇 달 동안 저장한 캡처 970개가 쌓여 있었어요. 그는 맥에 들어 있는 글자 인식으로 이미지 속 글자를 먼저 뽑고, 그 글자를 Jev가 읽어 폴더를 고르게 했어요. Jev는 그림을 보지 않고 글자만 봐요.

분류는 40초쯤 걸렸고 비용은 약 6센트였어요. 파일을 옮기기 전에 확인을 받았고, 민감해 보이는 캡처 42개는 따로 표시했어요. 옮긴 뒤에는 한 번에 되돌리는 명령도 남겼어요.

Finder 화면. Screendrop 폴더 안에 travel-and-visa, calendar-and-tasks, money, work 등 폴더 15개가 새로 생겼다
분류가 끝난 뒤 새로 생긴 폴더 15개. 출처: Fayaz Ahmed, X(2026-09-18)
터미널 화면. 970개 분류, 비용 약 0.0607달러, 민감할 수 있는 항목 42개, 옮기기 확인과 되돌리기 명령
970개 분류, 약 0.06달러, 민감할 수 있는 항목 42개, 되돌리기 명령. 확신이 낮은 파일에는 추정 확률이 붙어 있어요.

Reference 03마케팅 AI 도구 Maxfusion의 스타브(Stav Zilbershtein) · 자사 도구 시연

한 브랜드가 돌리는 광고 1,891개를, 19초 만에 고객 여정 단계별로 나눴어요

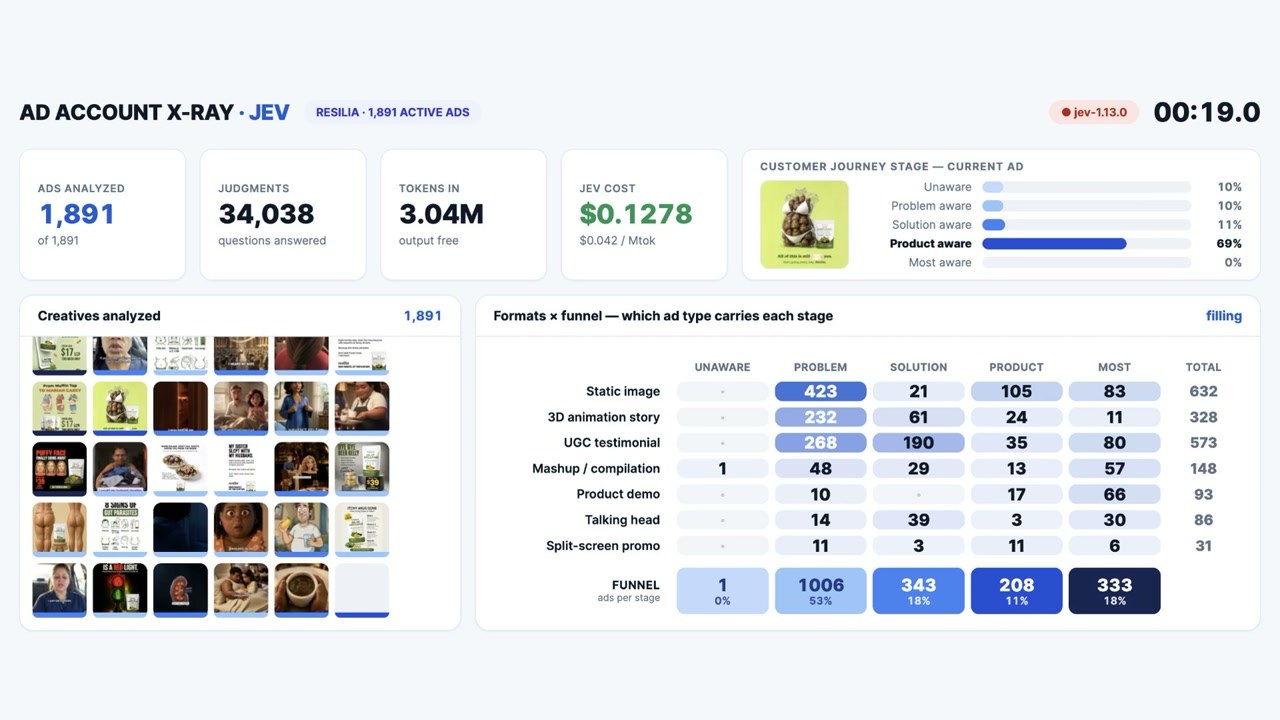
스타브는 Resilia라는 브랜드가 광고 라이브러리에 올려 둔 광고 1,891개를 Jev에 맡겼어요. 광고마다 고객 여정의 다섯 단계 가운데 어디를 노리는지, 어떤 형식의 광고인지를 물었어요. 다섯 단계는 문제를 모르는 사람부터 살 준비가 된 사람까지예요. 광고 이미지는 Gemini가 먼저 글로 풀었고, Jev는 그 글을 읽고 골랐어요.

19초 동안 판단 34,038개가 나왔고 비용은 13센트였어요. 광고의 절반이 넘는 1,006개가 문제를 알아차린 사람을 노렸고, 살 준비가 된 사람을 노린 광고는 333개였어요. 스타브는 이 기능을 자기 회사 도구에 넣을 예정이라고 밝혔어요.

AD ACCOUNT X-RAY 화면. 광고 1,891개, 판단 34,038개, 비용 0.1278달러, 19초. 광고 형식과 고객 여정 단계를 교차한 표
광고 형식(세로)과 고객 여정 단계(가로)를 교차한 표. 출처: Stav Zilbershtein, X(2026-09-18)

Reference 04미국 매체 Every의 평가 책임자 마이크 테일러(Mike Taylor) · 자기 글 27편

글 37편에 'AI 티' 질문 21개를 던지자, 0.7초 만에 판정 777개가 나왔어요

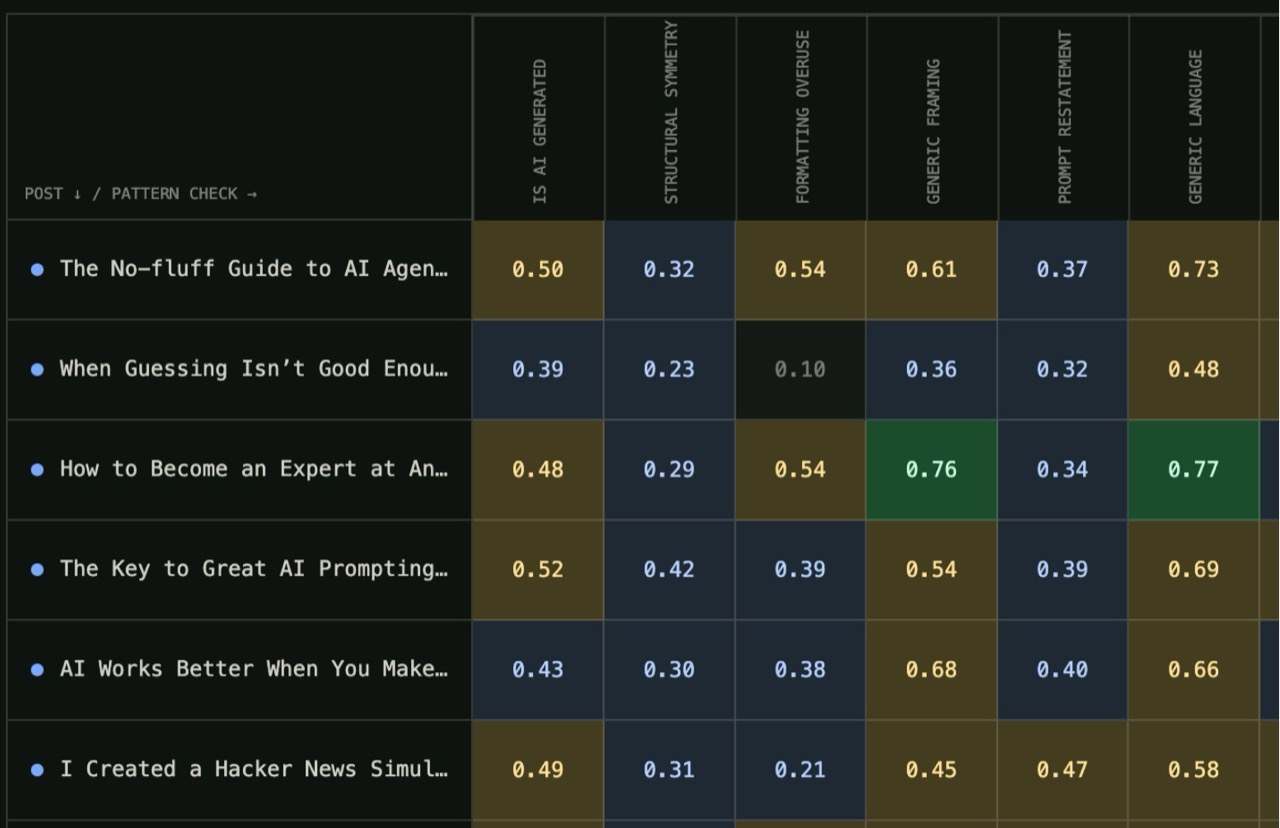
Every는 AI와 일하는 법을 다루는 미국 매체이고, 출시 1주 전부터 Jev를 미리 써 봤어요. 평가 책임자 마이크 테일러는 자기가 쓴 글 27편과, 일부러 AI 문체로 만든 글 10편을 Jev에 넣었어요. 질문은 Every가 글에서 AI 티를 잡으려고 쓰던 점검 목록에서 뽑은 21개였어요. 판정 777개가 0.7초 안에 나왔고, 비용은 0.25센트쯤이었어요.

다만 문체 패턴 하나하나의 점수를 평균 내는 방식은 통하지 않았어요. 마이크의 실제 글도 다듬은 구조와 수사 틀을 써서, 평균이 AI 문체 글보다 오히려 높게 나왔어요. 대표 댄 시퍼(Dan Shipper)가 따로 한 시험에서는 일부러 심은 결함 7개 중 6개를 잡았어요. 같은 시험에서 Claude Fable 5.1은 7개를 다 잡았지만, Jev가 25배쯤 빨랐고 비용은 약 580분의 1이었어요.

마이크는 실제로 쓰기 전에 정확도를 더 확인하고 싶다면서도, 아예 점검하지 않는 것보다는 먼저 울리는 경보로 쓸 만하다고 적었어요.

행은 글 제목, 열은 IS AI GENERATED, STRUCTURAL SYMMETRY 등 AI 문체 패턴이고 칸마다 0~1 사이 확률이 적힌 표
행은 글, 열은 AI 문체 패턴이에요. 1에 가까울수록 AI 티가 난다고 본 거예요. 출처: Every(스크린샷 Mike Taylor 제공)
Every가 던진 질문 21개 중 5개
  1. 1Does this writing appear likely to have been generated primarily by an AI? Judge only the text, not its topic or author metadata.
  2. 2Does the writing rely on generic framing instead of concrete context?
  3. 3Does the writing explain straightforward points more than necessary?
  4. 4Does the writing repeat the same idea without adding new evidence?
  5. 5Does the writing end with a generic offer to help or continue?

21개 전체는 Every 실험 사이트에 있어요.

써 본 사람들의 평

속도와 값은 칭찬이 압도적이에요. 정확도는 의견이 갈려요. 선택지가 분명한 분류에서는 작은 LLM과 비슷하거나 낫다는 사람이 있고, 미묘한 판단이나 보안 판단에서는 Haiku·Gemini보다 낮았다는 사람이 더 많아요. "0.8이라고 답하면 80%는 맞는다"는 확률 주장에는 반례가 많이 나왔어요. 가장 자주 나온 결론은 Jev를 1차 필터로 쓰고, 애매한 건 큰 모델이나 사람에게 넘기라는 거예요.

공식 홈페이지는 193.6배 빠르고 444.6배 싸다고 적었지만, 출시 뒤 나흘 동안 사용자들이 X에 적은 수치를 모아 보면 속도는 중앙값 7배, 값은 30배였어요.

좋았다는 평

  • “Probably around 750,000 classification problems, cost 26 cents and it did great job.”

    레시피 모음에 태그를 다는 분류 약 75만 건에 26센트가 들었고, 결과도 훌륭했어요.

    u/natlight · Redditreddit.com
  • “737 predictions had ≥99% confidence. Every one matched the reference label. Below 70% confidence, nearly half were wrong.”

    확신도 99% 이상인 737건은 모두 맞았고, 70% 아래는 절반 가까이 틀렸어요. 검토할 것을 고르는 데 쓸모가 있었대요.

    Nikhil Mudholkar(Bryo CTO) · Xx.com
  • “On Korean medical questions, taking only its most confident half cuts the error rate from 20% to 2%.”

    한국 의사국시 문항에서 확신도가 높은 절반만 받아들이자 오류율이 20%에서 2%로 줄었어요.

    MahlerLab · 의료 데이터 연구자ahn-lab.org
  • “Claude, codex 등 플러그인으로 사용해 봤는데 검증 결과가 나오는 속도가 장난 아닙니다.”

    @parktaegyun · 유튜브 댓글youtube.com

아쉬웠다는 평

  • “Jev's own verdict loses clearly on accuracy (McNemar p < 0.0001) and wins on speed and cost.”

    피싱 메일 2,000건에서 Jev는 62.6%, Haiku는 81.3%를 맞혔어요. 두 줄짜리 정규식 규칙은 91.6%였어요.

    anisselbd · GitHubgithub.com
  • “Jev always chose face 1 and the probability it returned was about 83%”

    공정한 주사위를 400번 물었더니 늘 1을 골랐고, 확률은 83%쯤으로 답했어요.

    kantahayashi · Hacker Newsnews.ycombinator.com
  • “Jev's median call was 6.3× faster than Sonnet's. Fast, but not 40–200×.”

    Sonnet보다 6.3배 빨랐어요. 빠르긴 하지만 공식 수치인 40~200배는 아니었어요.

    dchristopoulos · Hacker Newsnews.ycombinator.com
  • “0.9 이상이면 확실하다고 판단해도 될 줄 알았다. 그런데 애매한 task에 오히려 높은 confidence가 찍히는 경우가 나왔다.”

    원인은 Jev가 아니라, 보기의 경계를 서로 겹치게 짠 자기 설계였다고 적었어요.

    쵸코쿠키의 연습장 · 티스토리jjeongil.tistory.com

시작하는 법

  1. 1

    TypeSafe 콘솔에서 계정을 만드세요

    9월 27일 가입을 다시 열었고, 이때부터 새 가입자에게는 무료 크레딧을 주지 않아요. OpenRouter나 Vercel AI Gateway를 이미 쓰고 있다면 거기서 바로 부를 수도 있어요.

    console.typesafe.ai ↗
  2. 2

    플레이그라운드에서 질문 하나를 붙여 보세요

    아무 글이나 붙여 넣고 예·아니오 질문을 하나 달면, 답과 확률이 바로 나와요. 공식 문서의 예시 질문은 이거예요.

    공식 예시 질문

    Does this message express urgency?

  3. 3

    쓰던 AI 에이전트에 공식 스킬을 붙이세요

    Claude Code·Codex·Cursor 같은 에이전트에 스킬을 설치하면, 에이전트가 Jev를 부르는 코드를 대신 짜요.

    설치

    npx skills add typesafe-ai/skills --skill typesafe-ai

  4. 4

    맡길 판단을 한 줄로 말하세요

    스킬 저장소에 실린 예시 요청이에요. 확신이 낮은 판단은 사람이 보게 하라는 조건까지 들어 있어요.

    공식 예시 요청

    Use TypeSafe to route incoming support tickets by department, with human review for uncertain decisions.

  5. 5

    한국어 글은 몇십 건으로 먼저 맞춰 보세요

    공식 문서는 영어가 주 학습 언어이고, 한국어·일본어·중국어는 같은 수준이 아니라고 밝혀요. 숫자 계산과 날짜 비교도 약한 곳으로 적혀 있어서, 그런 판단은 코드에 맡기라고 권해요.

필요한 것

  • TypeSafe·OpenRouter·Vercel AI Gateway 중 한 곳의 API 키
  • 판단할 글(메일·문의·파일 속 글자 등 텍스트)
  • 스킬로 붙일 때는 쓰던 AI 에이전트

이 레퍼런스 공유하기

매주 1회 · 무료

이 레퍼런스가 도움이 되셨나요?

매주 쏟아지는 AI 소식 중 BEST
딱 3개만, 메일함에 꽂아 드릴게요

Work Smarter with AI

420명이 매주 받아보고 있어요

구독 완료 다음 호부터 메일함에서 만나요.