AI 编码用得不错,但月中预算就见底了
在一些组织中,引入 AI 编码工具后,合并 PR 等产出指标有所增长。 但管理后台会累积不同用户和模型的不同账单,很难解释谁在哪项工作上花了多少钱。如果选择只有“继续允许”和“全面封禁”,有价值的生产力信号也很容易一并丢失。
更实用的解法是:先让使用量变得可见,找出能通过实际工作质量标准的最低成本模型,再依次提高告警、切换和例外审批带来的摩擦。 Uber 为 AI 编码工具引入了按用户设置的限额和仪表板。 此外,该公司按任务调整默认模型,将部分工作转移到低成本和开放权重模型,并向员工提供支出信息;它表示,即使采用率持续增长,整体 AI 支出仍大致保持稳定。
这个案例并不意味着为了降低成本,就该强制所有开发者使用最便宜的模型。关键在于判断该相信哪些生产力指标,以及应从哪里开始更换模型的顺序。
Microsoft 的 24% 不是成本回报率
Microsoft 在 2026 年初的一项研究中发现,采用 Claude Code 或 Copilot CLI 的工程师,在之后 115 天内每位工程师每天的合并 PR 数量比合成对照组高 24.0%。贝叶斯 95% 区间为 14.5–33.7%。
这是一个显著的增长,但解读时需要谨慎。这并非随机实验,且衡量的是两种 CLI 工具合计的采用效果,而非 Claude Code 单独的效果。合并 PR 增多,也不直接意味着代码质量、客户价值或节省的人力成本有所提升。
观察期结束后不久,Microsoft 通知了一项内部政策:停止向大多数工程师提供 Claude Code 许可证,并转向 Copilot CLI。不过,论文没有公开停止了多少许可证,也没有说明成本是唯一或决定性的原因。
因此,公开证据能支持的结论仅止于此。 可以确认 Microsoft 决定更换工具,但没有经证实的依据可以泛化为“因成本关闭了超过 5,000 人的许可证”,或“AI 编码成本已经超过人力成本”。
Uber 改变的不只是上限,还有默认路径
据报道,Uber 在 2026 年 4 月已达到年度整体 AI 预算上限。对于 Cursor 和 Claude Code 等代理式编码工具,该公司设置了每名员工、每个工具每月 1,500 美元的上限,同时引入个人使用量仪表板和超限审批流程。
此外,Uber 在官方材料中解释为支出保持稳定背景的措施是按任务调整默认模型。它将部分工作转移到更便宜的模型和开放权重模型,并向员工提供支出信息。根据官方第二季度材料,近几个月每个 token 的成本有所下降;即使工具采用率增加,整体 AI 支出仍大致保持稳定。
不过,Uber 未披露使用量增长率、节省金额或按任务划分的质量变化。按用户设置的上限对支出稳定贡献了多少,也无法确认。“支出稳定”是有用的运营信号,但不应将其解读为证明质量得以维持的对照实验结果。
| 观察到的信号 | 不应立即断定的结论 | 下一步要核查的数值 |
|---|---|---|
| 合并 PR 增加 24% | 投资回报率也增加 24% | 每个获批产出的成本、缺陷、返工 |
| 年度整体 AI 预算提前耗尽 | AI 编码工具在经济上失败 | 使用量增长、按任务成本、被替代的时间 |
| 整体 AI 支出稳定 | 在没有质量损失的情况下成功节省成本 | 按模型划分的通过率、回滚、任务完成率 |
不是最便宜的模型,而是“通过质量标准的最便宜模型”
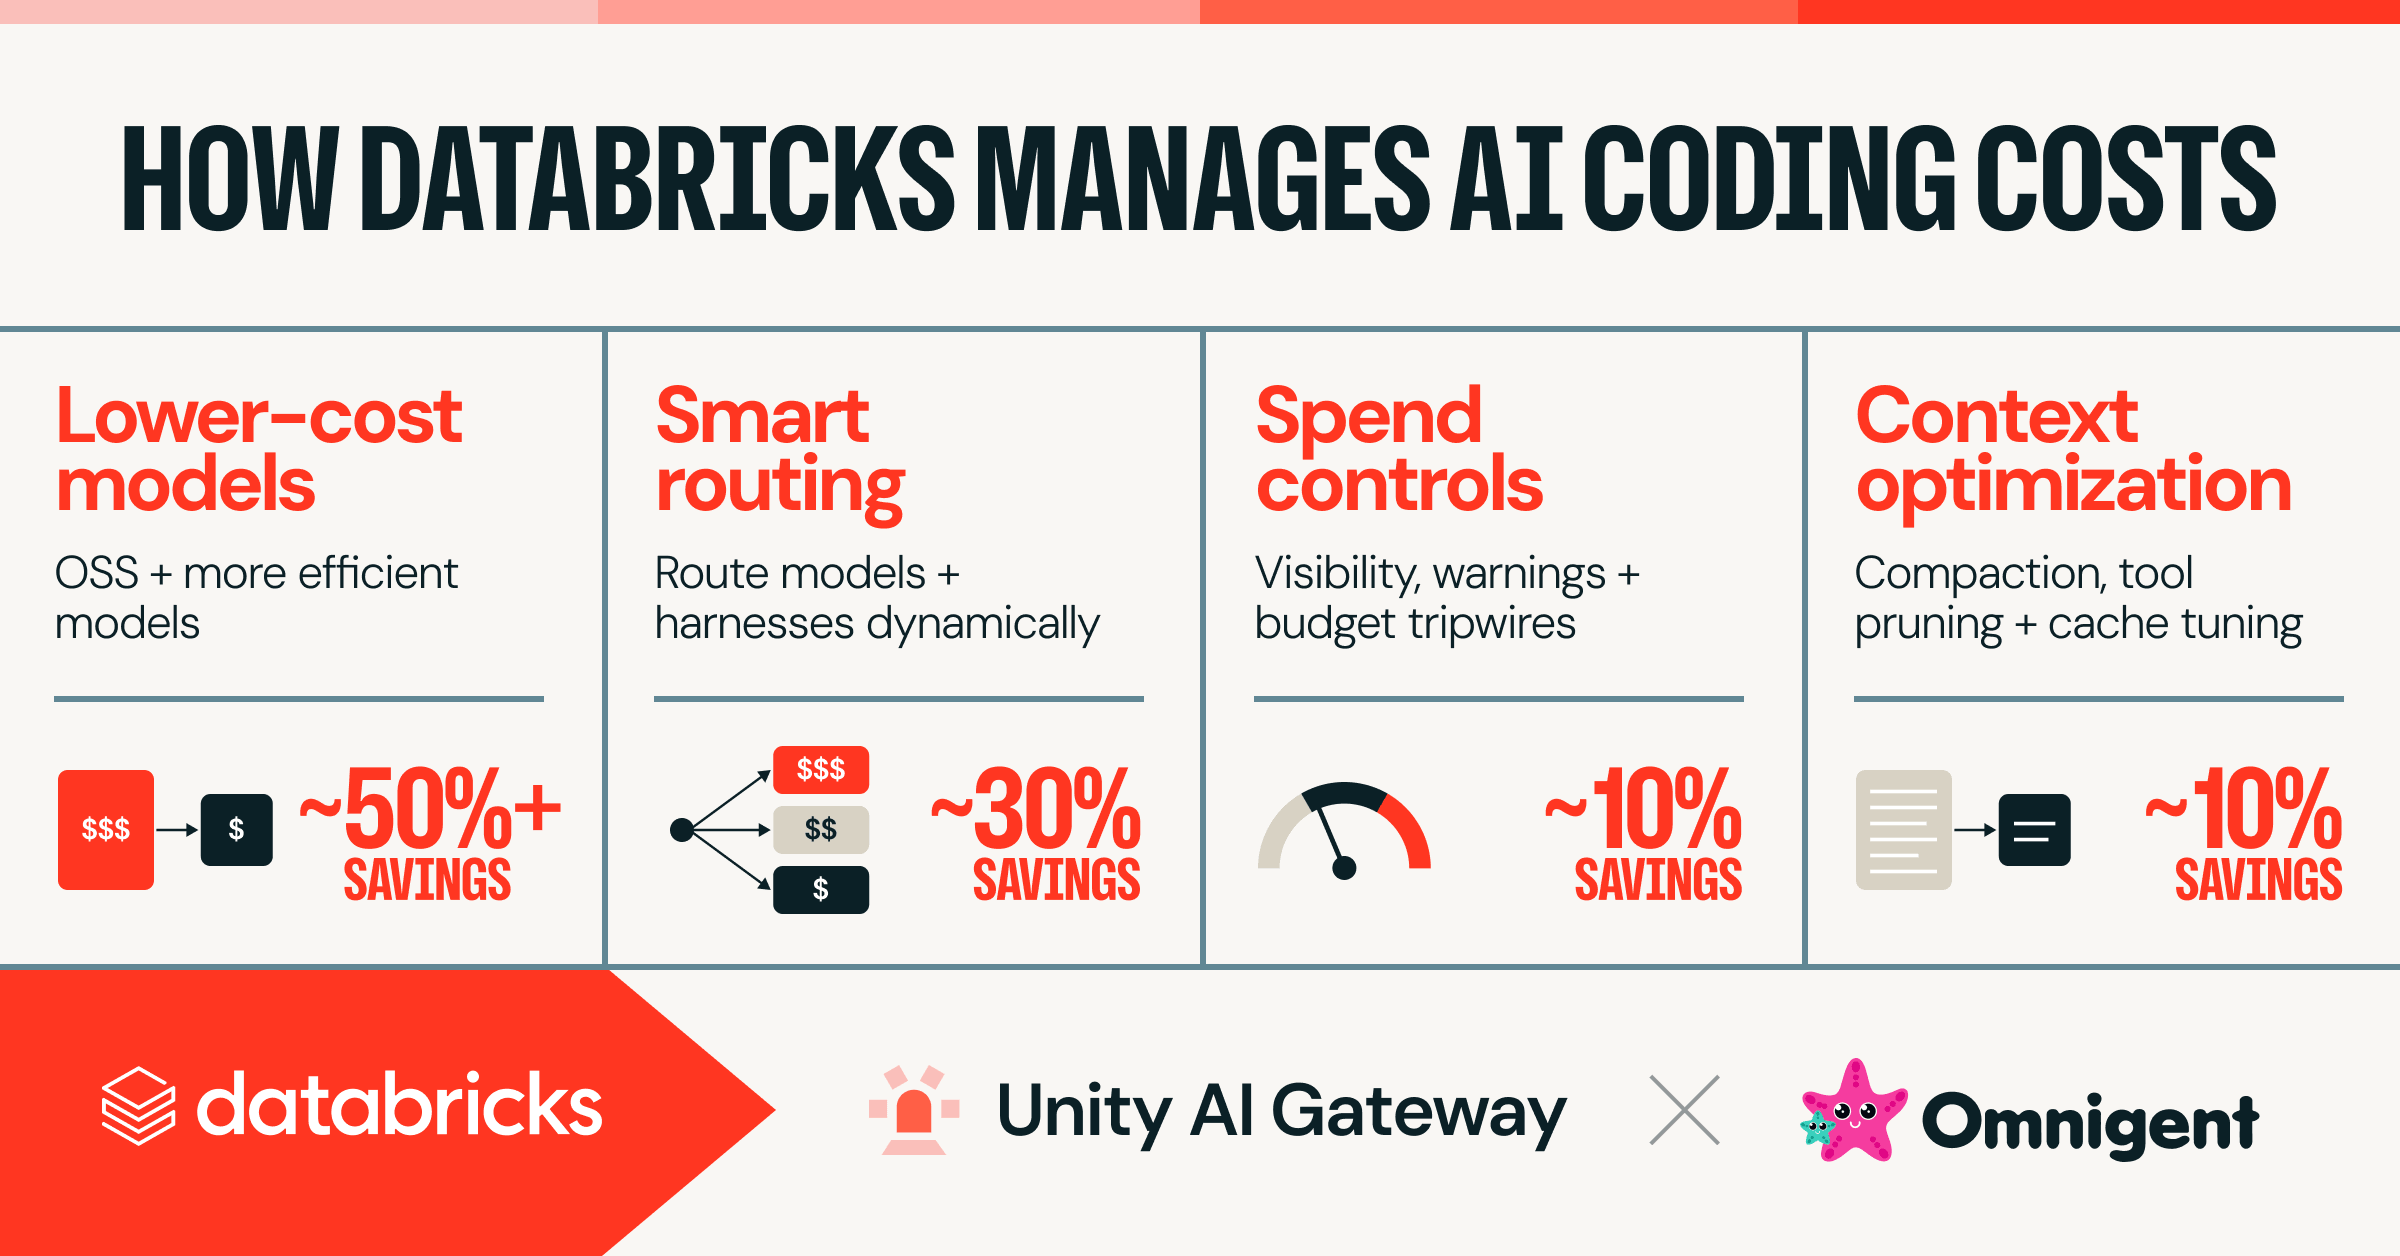
Databricks 提出的标准同样不是一刀切地采用最低价模型。公开编码基准可能无法充分代表实际内部工作,因此其方法是用重复出现的内部任务建立评估集,并选择在满足所需质量的模型中价格效率更高的模型。
在 Databricks 的内部结果中,Smart Router 将每项任务的平均成本降低了 30% 以上,同时产出的质量与比较对象中最昂贵的模型大致相当。减少不必要的推理调用、调整上下文压缩和缓存设置的工作,据称将生成 token 及相关成本降低了约 50%。
不应将这些数值直接写入预算方案。因为这是未公开目标任务、周期、样本、质量指标和原始成本的内部结果。应当借鉴的不是节省比例,而是分别测试按任务评估、路由和执行框架优化的结构。
今天就用最近四周的记录,只更换一个模型
在购买新的成本管理系统之前,先将管理仪表板、账单记录和 PR、CI 记录汇集到一张表中。如果使用 Claude Enterprise,可在管理控制台查看按群组、用户和模型划分的成本,以及 Claude Code 使用指标。还可以在组织支出上限的 75% 和 90% 设置管理员提醒。
- 将成本统一到同一单位。
按用户、团队、工具和模型汇总最近四周的记录,并同时列出席位订阅费和按量计费的超额费用。如果不同工具的用户标识符不一致,先通过员工编号或团队 ID 进行关联。 - 将结果和质量放在成本旁边。
关联合并 PR 或获批任务数量,并并列记录 CI 通过率、返工和回滚。如果先封禁花费最多的人,就无法区分承担困难任务的人和浪费使用量的人。 - 选择 3 到 5 项重复任务。
选择可以对齐输入和成功条件的任务,例如添加简单测试、修改文档或修复小型缺陷。对当前默认模型和低成本候选模型应用相同的测试与质量标准。 - 只为通过的任务降低默认模型。
仅对低成本模型达到相同质量标准的任务更改默认路径;对于复杂重构和模糊的故障分析,保留升级至高阶模型的例外路径。 - 从提醒开始,逐步提高摩擦。
依次制定公开当前支出、预算提醒、用户确认、管理员审批、切换至低成本模型和暂时暂停的政策。Claude Enterprise 的 75% 和 90% 提醒是预警功能,应与自动切换至低成本模型的功能区分开来。 - 变更后重新计算每项任务的成本。
检查每个获批产出的成本是否下降。如果缺陷和返工增加而抵消了节省额,请恢复默认模型或进一步缩小适用任务范围。
首次检查的成功标准
只要至少能针对一项重复任务比较按模型划分的质量通过率和每个获批产出的成本,并记录默认模型、提醒阈值和例外审批负责人,就已经足够。计算全公司的节省比例是下一步的事。
如果想进一步深入
Managing AI Coding Costs at Scale 可以了解如何按顺序连接内部评估、模型路由、执行框架优化和分阶段支出闸门。 databricks.com
Adoption and Impact of Command-Line AI Coding Agents 可以在原文中确认 Microsoft 的 24% 数值是基于何种群体、周期和方法计算的。 arxiv.org
Uber Q2 2026 Prepared Remarks 可以查看 Uber 在转向低成本和开放权重模型并提供支出信息后报告的成本变化。 investor.uber.com