採用経験のあるマネージャーが、応募者の志望動機書を読みます。いちばん下に、一文が添えられています。この文書は生成AIが作成した、という一文です。別のマネージャーもまったく同じ志望動機書を受け取りますが、その場所には、キャリアコーチが作成したと書かれています。さらに別のマネージャーが受け取ったものには、その一文自体がありません。
アリゾナ大学のOliver SchilkeとMartin Reimannが、採用経験のあるマネージャー85人を無作為に3つのグループに分けて行った実験です。評価する応募者は同じ人物で、応募したポストも同じ、志望動機書も同じ。違うのは、その一文だけでした。
コーチが代わりに書いたと明かしても、信頼スコアは下がりませんでした
マネージャーがつけた応募者の信頼スコアは、次のとおりです。
| 志望動機書に添えられた一文 | 応募者の信頼スコア | 一文のない志望動機書との比較 |
|---|---|---|
| 何も添えられていない | 4.40 | 基準 |
| キャリアコーチが作成しました | 4.32 | 差は有意でない(p = 0.81, d = 0.06) |
| 生成AIが作成しました | 2.91 | はっきりした差がある(p < 0.001, d = 1.42) |
研究チームがキャリアコーチの一文を入れたのは、信頼が下がったのが単に他人に仕事を任せたという事実のせいなのかを確かめるためでした。そして実験の結果は、その可能性を打ち消しました。コーチが書いたと添えた志望動機書と、何も添えていない志望動機書とでは、信頼スコアの差が統計的に意味のあるものではなかったのです。採用したいという意向でも、同じ順番になりました。
つまり、信頼スコアを下げたのは、本人が自分で書かなかったという事実ではありません。コーチが書いたと添えた志望動機書は何も添えていないものと同じスコアを受け、スコアが下がったのは、AIが書いたと添えた志望動機書だけでした。
この実験の参加者は85人です。研究チームは同じ比較を、もっと多くの人を相手にもう一度行いました。学部生195人に、教授が学期の最初の週に送る歓迎メッセージを見せ、同じように3つに分けたのです。課題を生成AIが採点すると書かれたメッセージを受け取った学生は、教授の信頼スコアを2.48とし、大学院生のティーチングアシスタントが採点すると書かれたメッセージを受け取った学生は2.87、採点者を書いていないメッセージを受け取った学生は2.96でした。ここでも、ティーチングアシスタントと書いた場合と何も書かなかった場合の差は有意ではありませんでした。投資家345人に同じ広告を見せた実験でも、順番は同じでした。
AIを使ったと伝える文言を6通りに変えても、6つとも何も書かない場合より信頼スコアが低くなりました
では、伝え方を工夫すればいいのでしょうか。研究チームはその問いで、もうひとつ実験を行いました。先ほどの志望動機書の実験からキャリアコーチの一文を外し、代わりに、AIを使ったと伝える文言を6通りに変えて添えたのです。
- 一般的な表現 AIを使ったとだけ書いたケースです。
- 人が確認して手を入れた 最終的な責任は人にあると伝えたケースです。
- 校正にだけ使った AIの役割を最小限に絞ったケースです。
- 使った理由を説明 使った意図を説明したケースです。
- 誤りが含まれている可能性がある AIの出力の限界を前もって伝えたケースです。
- 透明性を強調 開示することそのものを美徳として打ち出したケースです。
6つの文言はどれも、何も添えていない志望動機書より信頼スコアが低くなりました。p値はいずれも0.02未満です。採用したいという意向でも、同じ順番になりました。
開示をルールで義務づければ変わるのではないかと考え、研究チームはもう一度実験しました。参加者を分け、州政府がAI使用の開示を義務化しようとしているという記事か、各自の判断に任せようとしているという記事を読んでもらってから、同じデザイナーを評価してもらったのです。義務化の記事を読んだ人も任意の記事を読んだ人も、AIを使ったと明かしたデザイナーに低い信頼スコアをつけました。結果は変わりませんでした。
"Thirteen experiments consistently demonstrate that actors who disclose their AI usage are trusted less than those who do not."(13の実験が一貫して示しているのは、AIの使用を開示した人が、開示しない人より信頼されないということだ)
— Schilke & Reimann, Organizational Behavior and Human Decision Processes (2025)
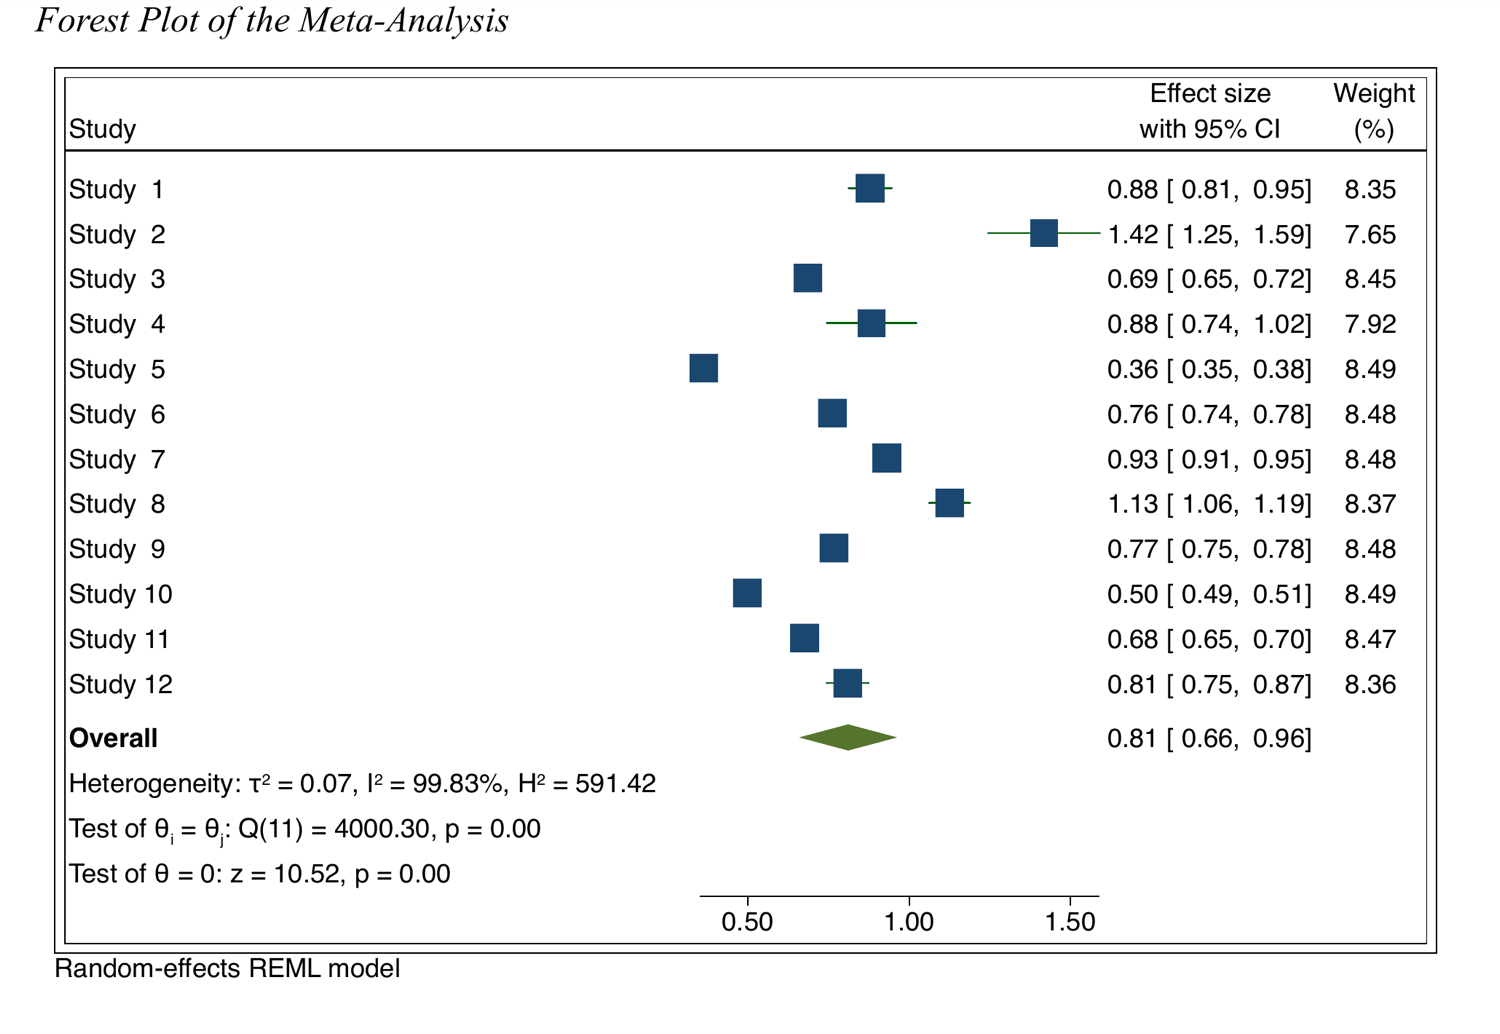
この論文を信頼できる理由は、実験の数だけではありません。13の実験はすべてデータ収集の前にOSFで事前登録されていて、実験ごとの登録リンクが表に載っています。参加者の数はあらかじめ計算して決めてあり、あとから除外したデータもありません。データ、分析用のコード、操作チェックまで公開されています。13の実験をまとめたメタ分析の対象は、4,093人です。
2026年、米国のナレッジワーカーの94%がすでにAIを使っています
ここまでは、研究チームが条件をコントロールした実験です。今年6月には、AtlassianのTeamwork Labが米国のナレッジワーカーを対象に、同じ問いを職場の文脈で投げかけました。
別に行った1,006人の調査では、94%が先月仕事でAIを使ったと答え、8割ほどがマネージャーや同僚にそのことを隠していないと答えました。さらに961人を対象にした統制実験では、事業提案を要約した同じメールを同じ架空の同僚が書いたものとして見せ、その仕事をどう進めたかを書いた一行だけを変えました。AIを使ったと書かれたメールを見た人は、その同僚を目立つプロジェクトに推薦するよう役員に勧めると答えた割合が、24ポイント低くなりました。
Atlassianは、書き方を変えるとどこまで和らぐかも調べています。「saved me time(自分の時間が浮いた)」と書いたメールより、「supporting the team and client(チームとクライアントのために使った)」と書いたメールのほうが、努力を認めるという回答が45%から56%に、推薦するという回答が43%から51%に上がりました。ただ、どちらのメールも、AIにまったく触れていないメールよりは低い結果でした。
AtlassianはAI製品を販売している会社で、この結果は論文として発表されたものではありません。
ひとつ重なる点はあります。Atlassianは、AIの利用を奨励している会社では、AIを使ったと明かしても不利益はほとんどなかったと報告しています。SchilkeとReimannも、周囲がAIの利用を当たり前と受け止めている状況では信頼スコアの下がり幅が小さくなることを、実験で確かめています。2つの調査が同じ結果を出したのです。
AIを使ったと言わなかったアドバイザーのスコアがいちばん高く、ばれるといちばん低くなりました
最後の実験は税務相談です。参加者195人が、Charlesという税務アドバイザーとチャットで還付額について相談します。参加者は3つに分けられました。アドバイザーがAIを使ったと自分から明かすチャットを見た人、アドバイザーがAIを使っていたことが第三者を通じて明るみに出るチャットを見た人、そうした話がまったく出てこないチャットを見た人です。
同じ実験、同じ尺度で出た3つのスコアです。アドバイザーが自分から明かしたときのスコアはAIへの言及がないときより低く、第三者が明るみに出したときは、自分から明かしたときよりさらに低くなりました。3つのスコアの差は、いずれも統計的にはっきりしていました。
ですから、この研究が教えてくれるのは、こうすべきだという勧めではなく、何をするとスコアがどうなるかです。AIを使ったと言わないのが、いちばんスコアが高くなります。そのスコアは、誰にも知られていないあいだしか保てません。13の実験が終わっても、答えの出ていない問いがあります。94%が使っているものを、言えば損をし、ばれればもっと損をする状態のまま、いつまで放っておけるのでしょうか。