一位有招聘经验的经理在读应聘者的求职信。信的末尾附着一句话:这封信由生成式 AI 撰写。另一位经理收到的是一模一样的求职信,只是那个位置写着由职业教练撰写。还有一位经理收到的信上,压根没有这句话。
这是亚利桑那大学的 Oliver Schilke 和 Martin Reimann 做的实验:把 85 位有招聘经验的经理随机分成三组。他们评价的是同一位应聘者,应聘的是同一个职位,求职信也一样。唯一的不同,就是那一句话。
写明由职业教练代笔,信任得分并没有下降
经理们给应聘者打出的信任得分如下。
| 求职信末尾附带的那句话 | 应聘者信任得分 | 与没有附言的求职信相比 |
|---|---|---|
| 什么都没附 | 4.40 | 基准 |
| 由职业教练撰写 | 4.32 | 差异不显著(p = 0.81, d = 0.06) |
| 由生成式 AI 撰写 | 2.91 | 差异明显(p < 0.001, d = 1.42) |
研究者加入职业教练这一句,是想确认信任下降是不是仅仅因为把活儿交给了别人。实验结果排除了这种可能:注明由教练代写的求职信,和什么都没注明的求职信相比,信任得分的差异在统计上并不显著。在录用意愿上,三组的排序也一样。
所以,拉低信任得分的,并不是没有亲手写这件事。注明由教练代写的求职信,和什么都没注明的得分相同;分数下降的,只有注明由 AI 撰写的那一封。
这项实验的参与者是 85 人。研究者又找了更多人,把同样的比较再做了一遍:给 195 名本科生看教授在学期第一周发来的欢迎信息,同样分成三组。信息里写着作业由生成式 AI 批改的那组学生,给教授的信任打分为 2.48;写着由研究生助教批改的那组是 2.87;没写由谁批改的那组是 2.96。这里同样,写明助教和不写之间的差异并不显著。给 345 位投资者看同一则广告的实验,排序也一样。
把说明 AI 使用的那句话换成六种说法,六种都比不写的信任得分低
那么,换个说法行不行?研究者为此又做了一项实验:在前面的求职信实验里拿掉职业教练那一句,改为附上六种不同的 AI 使用说明。
- 一般说法 只写了用过 AI。
- 经过人工审核和修改 表明最终责任在人。
- 只用于校对 把 AI 的作用限定到最小。
- 说明使用原因 解释了用 AI 的用意。
- 可能存在错误 预先告知 AI 产出的局限。
- 强调透明公开 把公开本身当作美德来强调。
六种说法全都比什么都没附的求职信信任得分低,p 值都小于 0.02。录用意愿的排序也一样。
如果由规定强制公开,会不会不一样?研究者又做了一次实验:先让参与者分组阅读报道,一篇说州政府打算强制要求公开 AI 使用,另一篇说打算交由各方自愿决定,然后请他们评价同一位设计师。不管读的是强制公开还是自愿公开的报道,表明自己用了 AI 的设计师信任得分都更低,结果没有改变。
"Thirteen experiments consistently demonstrate that actors who disclose their AI usage are trusted less than those who do not."(13 项实验一致表明:公开自己使用了 AI 的人,比不公开的人更不受信任。)
— Schilke & Reimann, Organizational Behavior and Human Decision Processes (2025)
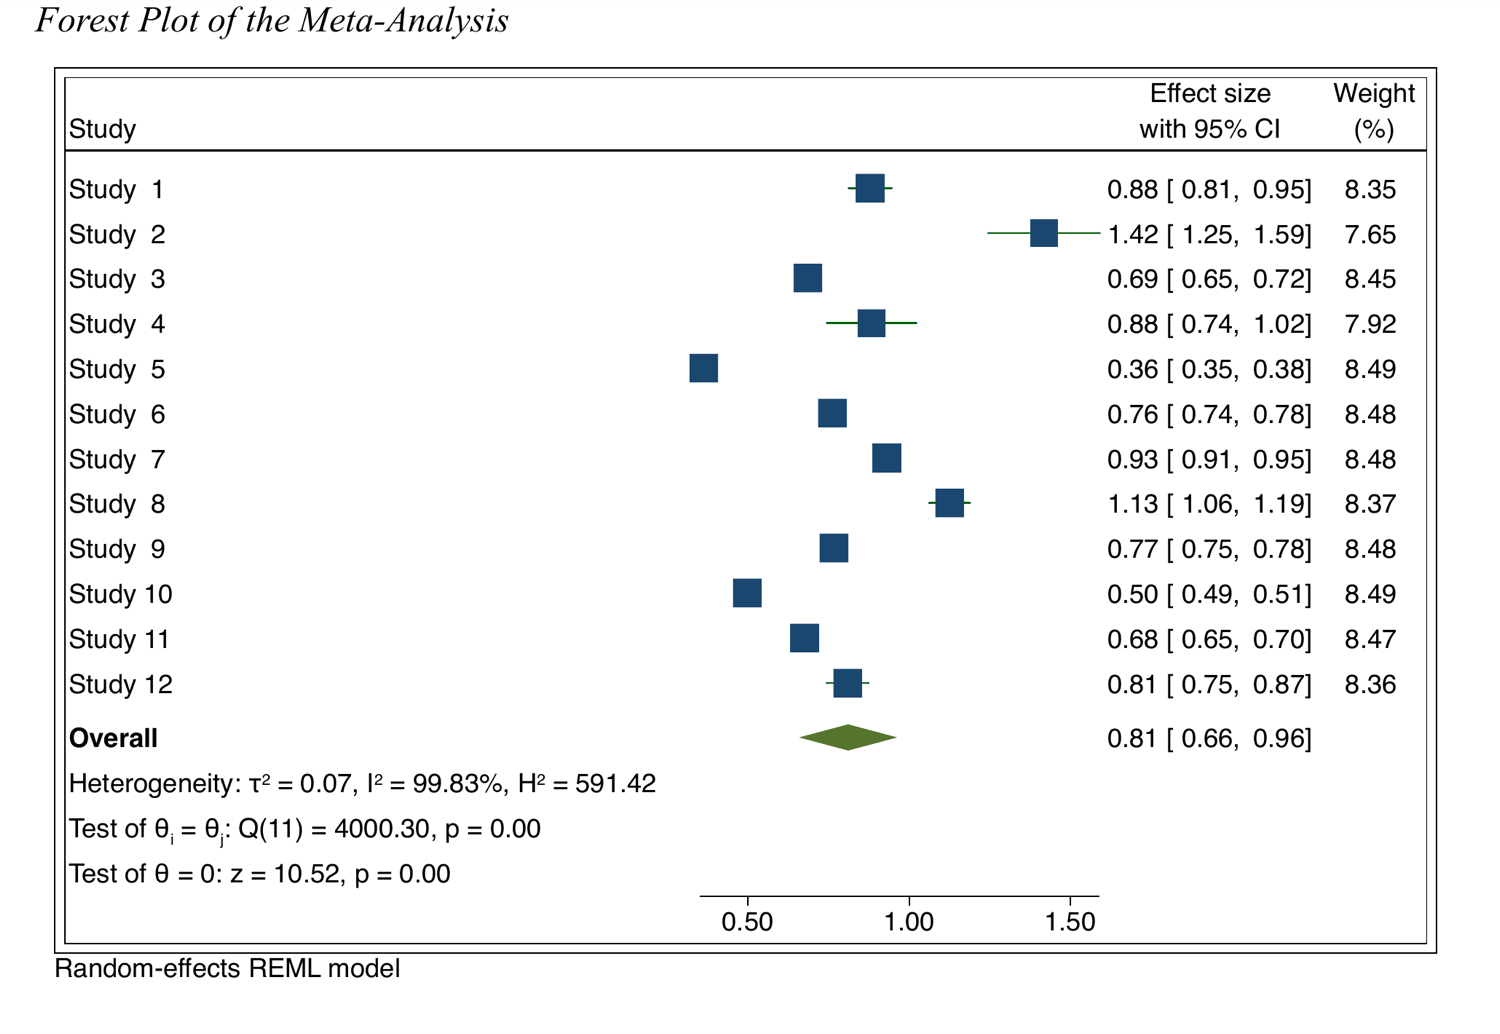
这篇论文可信,不只是因为实验多。13 项实验全部在收集数据之前就在 OSF 上做了预注册,每项实验的注册链接都列在表格里。参与人数事先计算确定,事后也没有剔除任何数据。数据、分析代码乃至操纵检验都已公开。把 13 项实验合并起来做的元分析,样本共 4,093 人。
2026 年,94% 的美国知识工作者已经在用 AI
以上是研究者控制了条件的实验。今年 6 月,Atlassian 的 Teamwork Lab 面向美国知识工作者,把同样的问题放到了职场情境里。
在另行开展的 1,006 人调查中,94% 的人表示上个月在工作中用过 AI,约八成表示没有向经理和同事隐瞒这一点。在另一项面向 961 人的对照实验中,研究者给参与者看同一封总结商业提案的邮件,说明都出自同一位虚构的同事,只改动其中描述这项工作是怎么完成的那一行。看到邮件里写着用了 AI 的人,表示会向高管推荐让这位同事负责备受关注的项目的比例,低了 24 个百分点。
Atlassian 还考察了换种说法能缓解多少。和写着“saved me time”(帮我省了时间)的邮件相比,写着“supporting the team and client”(为了支持团队和客户)的邮件,在认可其付出的回答上从 45% 升到 56%,在愿意推荐的回答上从 43% 升到 51%。但两种邮件的结果,都低于完全没提 AI 的邮件。
Atlassian 是一家销售 AI 产品的公司,这项结果也没有以论文形式发表。
有一处是吻合的。Atlassian 报告说,在鼓励使用 AI 的公司里,说出自己用了 AI 几乎不会吃亏;Schilke 和 Reimann 也通过实验确认,当周围的人都把使用 AI 视为理所当然时,信任得分的降幅会变小。两项研究得出了同样的结果。
不提用了 AI 的顾问得分最高,被揭穿的得分最低
最后一项实验是报税咨询。195 名参与者通过聊天,向一位名叫 Charles 的税务顾问咨询退税金额。参与者分成三组:一组看到顾问主动说明自己用了 AI 的聊天记录,一组看到经由第三方曝光顾问用了 AI 的聊天记录,还有一组看到的聊天里根本没提这件事。
这是同一项实验、同一套量表下的三个得分。顾问主动说明时的得分低于没有提到 AI 时,被第三方曝光时又比主动说明时更低。三者之间的差距在统计上都很明显。
所以,这项研究告诉我们的不是应该怎么做,而是做了什么、得分会怎样。不说自己用了 AI,得分最高;但这个得分只在没人知道的时候才保得住。13 项实验做完,仍然没有答案的问题是:94% 的人都在用的东西,说出来吃亏,被发现吃更大的亏,这种状态还能维持多久?