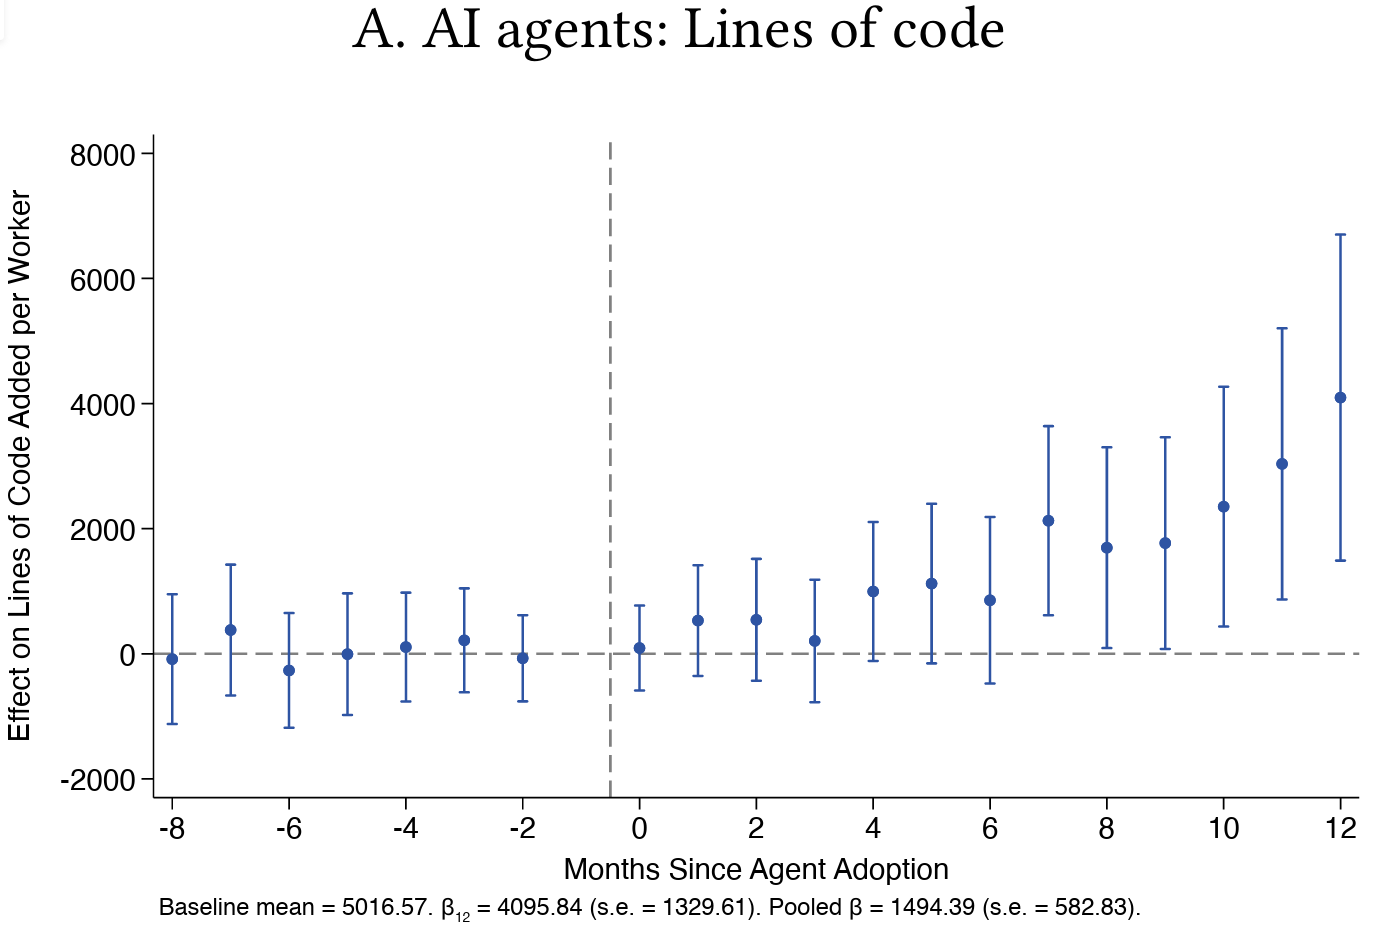
ハーバード大学の研究チームは、企業にAIが導入された後、ソフトウェア開発の仕事がどう変わったかを調べるため、エンジニアやマネージャーにインタビューしました。あるジュニアソフトウェアエンジニアは、大量のコミットを素早く作れるようになった一方、コードレビューは依然としてボトルネックだったと話しました。あるプロジェクトでは、コードベースを最もよく知るシニアエンジニア1人しか変更を承認できませんでした。その人は多忙で、このエンジニアのコードを週に1回しか見られなかったといいます。研究チームが718社の作業記録から得た数字も、同じ方向を示しています。コーディングエージェントの導入後、コード量は30%増えましたが、会社が完了した仕事は増えたとはいえませんでした。
比較対象はAIのない時代ではなく、コード補完AIだけを使っていた時
ハーバード大学のFiona ChenとJames Strattonは、開発分析会社Jellyfishの顧客のうち、研究利用に同意した718社、725,938人の記録を分析しました。期間は2021年1月から2026年3月までで、約6,800万件のJira課題、約2億件のコミット、約4,900万件のPR(コード変更の取り込み依頼)が含まれます。研究チームはコミット内のコードの中身を見ず、誰がいつ何を提出し、マージしたかを記録したデータだけを調べました。
比較には、企業ごとにツールを導入した時期が違うことを利用しました。ある企業では1件の購入に調達・法務・セキュリティ・ITの4チームが関わり、ChatGPTが登場した2022年11月からほぼ1年後の2023年秋になって、ようやく試用ライセンスを数件購入しました。別の企業では、ITと法務に確認すれば通常1日以内に承認が下りるといいます。研究チームは、早く導入した企業を遅く導入した企業や導入しなかった企業と比較する、導入時期のずれを利用した差の差分析を用い、企業規模を統制しました。
比較の基準には注意が必要です。研究チームは、コード補完型のAIアシスタント(Copilot・Cursor)と、自ら作業を進めるエージェント(Cursor Agent・Claude Code・Devinなど)の効果を別々に推定しました。エージェントの効果は、AIがまったくない状態との比較ではなく、アシスタントを使っていた状態にエージェントを加えたときの追加的な変化です。エージェントを導入した企業の割合は、2024年10月のほぼ0%から2026年1月には95%以上に上昇しました。
アシスタントだけを導入した場合、PRの増加は約5%で、統計的に有意ではありませんでした。この論文は著者が学界の採用市場に提出するジョブマーケットペーパーで、査読を受けたという記載はありません。データは開発生産性指標を販売するJellyfishから提供されました。論文には、結論は著者自身のものであり、Jellyfishは機密情報が明らかになっていないかを確認しただけで、科学的内容は検討していないと記されています。
「完了した仕事」はレビューとテストを経て本番環境にデプロイされた作業
研究チームは、企業が実際に完了した仕事を、解決済みのJira課題数で測りました。この論文では、課題の解決とは、コードがレビューとテストを経て本番環境にデプロイされたことを意味します。どれだけ多くコードを書いても、レビューを通過してデプロイされなければ、この件数には入りません。エンジニア1人が1か月に解決する課題は平均3.67件で、エージェント導入の効果は+0.12件、標準誤差は0.17でした。ゼロと区別できない値です。機能やプロジェクト単位のエピックでも、有意な効果はありませんでした。
原論文は、95%信頼区間で見ると、基準平均の12%を超える効果は排除できるとしています。同じ企業でコード量は30%増えたものの、デプロイまで完了した仕事の増加は、あったとしても12%未満という結果です。
課題一つひとつが大きくなり、件数だけが横ばいに見えた可能性もあります。研究チームはこれを2つの方法で確認しました。1つはGPT-4oで課題の0.5%に予想所要時間を付け、それを学習したモデルで全課題に推定を広げる方法です。もう1つは、課題を1件完了するまでにかかると予想される期間、すなわち予測サイクルタイムを使う方法です。結論は、課題の構成が変わった証拠はないというものでした。研究チームはコード行数やコミット数という指標自体にも疑問を投げかけています。
「多くのマネージャーはコード行数やコミット数のような中間的な生産性指標に頼っているが、それらはAI導入による真の効果を正確に捉えられない可能性がある。」
多くのマネージャーがコード行数やコミット数のような中間指標を見るものの、それだけではAI導入の実際の効果を正しく把握できないかもしれない、という意味です。
コード変更の提出から人のレビューを経てマージされるまで、7日から10.5日に延びた
増えたコードがどこにたまったのかを見るため、研究チームはPRの提出日からマージ日までの日数を調べました。エージェント導入後、この期間は平均7.03日から3.45日延び、約10.5日になりました。標準誤差は1.60です。統計的に有意ですが、推定の幅が広い数字です。アシスタントだけを使った企業では、この期間に有意な変化はありませんでした。
より推定の幅が狭い数字は、レビューの内容から得られました。修正を求められたPRの割合とPRあたりのレビューコメント数は大きく増えましたが、PRのサイズは有意に変化しませんでした。そのため、PRが大きくなったからコメントが増えたという説明は、この結果に合いません。
| 指標 | 基準平均 | エージェント導入の効果 | 読み方 |
|---|---|---|---|
| PR提出からマージまで | 7.03日 | +3.45日(標準誤差1.60) | 有意だが推定の幅が広い |
| 修正を求められたPRの割合 | 0.13 | +0.12(標準誤差0.01) | ほぼ2倍 |
| PRあたりのレビューコメント | 1.66件 | +0.58件(標準誤差0.11) | 35%増 |
| PRあたりの追加行数 | 1,167.97行 | −67.99行(標準誤差126.91) | 有意ではない |
先ほどのジュニアエンジニアは、インタビューでこう付け加えました。
「AIが生成したコミットによる障害が何度か起きた後、AI生成コードにはシニアエンジニアの承認を必要とする新たなルールもでき、レビューのボトルネックがさらに深刻になりました。」
AIが生成したコミットによる障害の後、AIコードにはシニアの承認を求めるルールができ、レビュー待ちがさらに長くなったという話です。著者は、この引用を意味が明確になるよう軽く編集したと明かしています。
修正要求が増えたからといって、バグが増えたとは断定できません。論文のモデルは、この変化を初稿の品質低下による可能性(bug-rate channel)として解釈していますが、論文にバグ・リバート・障害の件数はなく、インタビューでのエピソードしかありません。この解釈は、データ提供元の宣伝とも異なります。Jellyfishは2026年1月のブログで予備版(500社、10万人)を紹介し、「コード品質が損なわれているようには見えない」と書きました。Hacker Newsでは、もともとのボトルネックはレビューではなく品質であり、レビューは品質問題が表面化する場所にすぎないという反論も出ました。
同じ人員の中で、レビューを担うエンジニアの割合は0.29から0.33に上昇
企業内の役割分担も変わりました。エンジニアのうちレビューを行う人の割合は0.29から0.04上がり、14%増えました。一方、コードを書く人の割合(0.43)に有意な変化はありませんでした。雇用規模も有意には変化しませんでした。エージェント導入後、全体の雇用が2.9%を超えて減少した可能性と、エンジニアの雇用が13.8%を超えて減少した可能性は排除され、ジュニアとシニアのどちらにも有意な変化はありませんでした。人を追加採用しないまま、同じ人員の中でレビューを担う人の割合が増えたという結果です。
AIコードレビューツールも急速に普及しました。2026年3月時点で、標本企業のほぼ80%がAIレビューツールを試していました。しかし、レビューコメント全体のうちAIによるものは23.3%で、AIのコメントを1件以上受けたPRは10.8%でした。残る76.7%のコメントは人が書いています。原論文は、AIレビューツールを導入してもレビューのボトルネックは残ると結論づけています。
Hacker Newsのある開発者は、シニアエンジニアにとって1行ずつのレビューを手放すのは非常に難しいと書きました。この開発者は、最初から人によるレビューを設けないスタートアップでは違う展開になると述べ、そうした組織は今回のような標本には入りにくいと指摘しました。論文の公開説明には、この点を個別に分析した内容はありません。
AIがコーディングを速めても、完了する仕事の量は人のレビュー速度に左右される
論文の付録に登場するシニアエンジニアは、この構造をこう語っています。
「ボトルネックは一度に1つしかありません。コーディングを速めれば、ボトルネックは別の場所に移ります。... 今では機能をずっと速く生成できますが、それでも人による検証と承認が必要です。」
Jellyfishの記録に基づく推定では、エンジニアは勤務時間の42.0%をコードの作成に、18.6%をレビューに、39.5%を管理業務に使っています。エージェントが速めたのは、このうちコードを書く部分です。しかし、コードをデプロイするには人のレビューを通る必要があります。コードが増えると、レビュー1件あたりの仕事も増えました。修正を求められるPRはほぼ2倍になり、PRあたりのレビューコメントも35%増えました。企業内では同じ人員のうちレビューを担う人の割合が14%増えましたが、新規採用ではなく、レビューに移った人たちです。
人をレビューに移すだけで十分かどうかも、まだ分かりません。原論文は、ボトルネックが初稿の品質にあるなら、人をレビューに移すだけでは解決せず、技術自体の改善が必要だとしています。修正を求められたPRがほぼ2倍になったことが品質問題の兆候なのかは、バグの記録がないため、この論文だけでは判断できません。いずれにせよ、増えたコードが滞ったのは人によるレビューの段階でした。
この結果には時期の制約があります。データは2026年3月で終わっており、Ars Technicaは、その後もエージェントが大きく改善し、多くの企業がまだ使い方を学んでいる段階だと指摘しました。データは非公開のため外部から再現できず、個人ライセンスで使われたエージェントは導入記録に含まれません。
これまで多くのマネージャーは、エンジニアがどれだけ多くコードを書くかに注目してきました。コーディングエージェントによってコード行数は30%増えましたが、デプロイまで完了した仕事が増えたとはいえませんでした。これから注目すべきは、そのコードがどれだけ速く、何回のレビューで人の確認を通過するかです。
さらに詳しく読む
Artificial Intelligence in the Firm: Bottlenecks in Software Production ChenとStrattonによる論文の原文です。第4節にレビューのボトルネックの分析、付録Bにエンジニアへのインタビューがあります。 fion.ac
Harvard researchers find AI coding agents shifted the bottleneck to code review 論文とJellyfishの関係、予備版の宣伝と現行版の解釈の違いを検討した批判的な記事です。 complexdiscovery.com
AI coding agents generate more code, but not more software 原論文の図表や数字を紹介し、データの時点による限界を指摘した記事です。 arstechnica.com