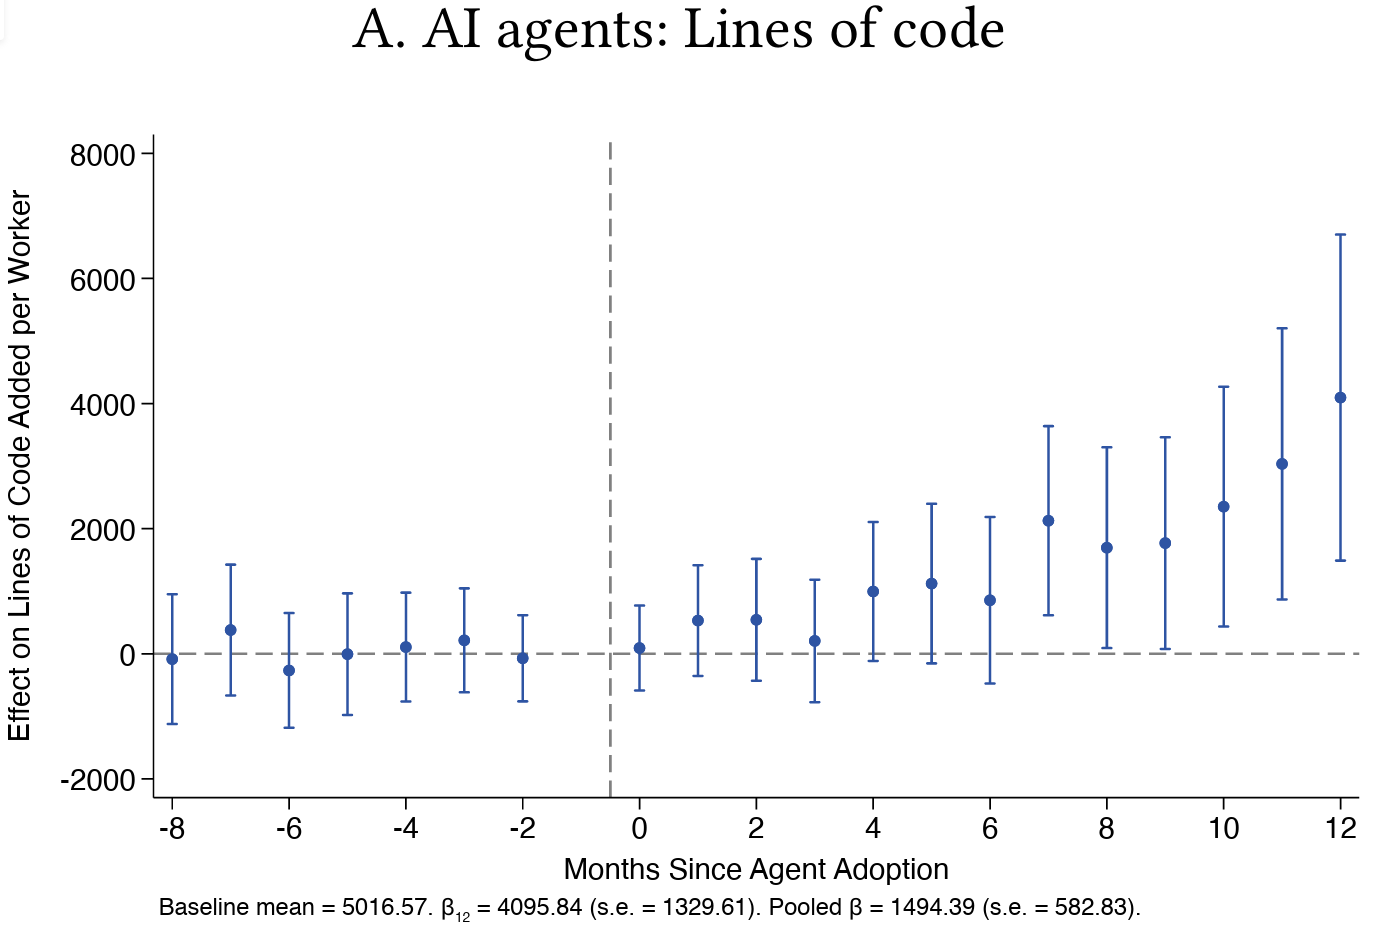
哈佛大学研究人员为了了解企业引入AI后软件开发工作发生了什么变化,采访了工程师和管理者。一名初级软件工程师说,人们可以快速提交大量代码,但代码审查仍是瓶颈。在一个项目中,只有一名最熟悉代码库的高级工程师能够批准变更。那个人太忙,每周只能看一次这名工程师的代码。研究人员从718家公司的工作记录中得出的数字也指向同一个方向:引入编程智能体后,代码量增加了30%,但无法认定公司完成的工作有所增加。
比较对象是只用代码自动补全AI的时候,而不是没有AI的时候
哈佛大学的Fiona Chen和James Stratton分析了开发分析公司Jellyfish客户中同意数据用于研究的718家公司、725,938人的记录。数据覆盖2021年1月至2026年3月,包括约6,800万条Jira问题、约2亿次提交和约4,900万个PR,即代码变更合并请求。研究人员没有查看提交中的代码内容,只查看了谁在何时提交和合并了什么的记录。
研究利用了各家公司引入工具的时间差异。一家公司的一笔采购涉及采购、法务、安全和IT四个团队,直到2023年秋天才购买了几个试用许可证,那时距离ChatGPT于2022年11月推出已近一年。另一家公司则表示,向IT和法务部门咨询后,通常一天内就能获得批准。研究人员采用错位双重差分法,将较早采用的公司与较晚采用或没有采用的公司进行比较,并控制了公司规模。
比较基准需要看清楚。研究人员分别估计了代码自动补全型AI助手(Copilot、Cursor)和能自主推进任务的智能体(Cursor Agent、Claude Code、Devin等)的效果。智能体的效果不是与完全没有AI的状态相比,而是在已经使用助手的基础上加入智能体所带来的额外变化。采用智能体的公司比例从2024年10月的接近0%升至2026年1月的95%以上。
只引入助手时,PR数量增加约5%,但在统计上并不显著。这篇论文是作者在学术招聘市场提交的求职论文,没有标明经过同行评审。数据来自销售开发生产力指标的Jellyfish。论文称,结论属于作者本人,Jellyfish只检查是否披露了专有信息,没有审查科学内容。
研究中“完成的工作”是经过审查、测试并部署到生产环境的工作
研究人员用公司解决的Jira问题数量衡量实际完成的工作。在这篇论文中,问题得到解决意味着代码已经过审查和测试,并部署到生产环境。代码写得再多,如果没有通过审查并部署,就不会计入这一数量。每位工程师每月平均解决3.67个问题,引入智能体的估计效果为增加0.12个,标准误差为0.17,无法与零区分。以功能或项目为单位的Epic也没有出现显著效果。
论文指出,根据95%置信区间,可以排除超过基准平均值12%的效果。也就是说,在代码量增加30%的同一批公司中,即使完成部署的工作有所增加,增幅也不到12%。
也有一种可能:每个问题变大了,所以数量看起来没有变化。研究人员用两种方法检验了这种可能性。一种是用GPT-4o为0.5%的问题估计所需时间,再用训练出的模型将估计扩展到所有问题;另一种是使用完成一个问题的预计时长,即预测周期时间。结论是,没有证据表明问题的构成发生了变化。研究人员也对代码行数和提交次数这些指标本身提出了疑问。
“许多管理者依赖代码行数或提交次数等中间生产力指标,但这些指标可能无法准确反映引入AI带来的实际收益。”
也就是说,许多管理者关注代码行数或提交次数等中间指标,但这些指标可能无法准确反映引入AI的实际效果。
代码变更从提交到通过人工审查并合并,时间从7天延长至10.5天
为了查看增加的代码积压在哪里,研究人员测量了从PR提交到合并的天数。引入智能体后,这段时间从平均7.03天增加了3.45天,达到约10.5天,标准误差为1.60。这一变化在统计上显著,但估计的不确定范围较宽。只使用助手的公司在这段时间上没有显著变化。
审查内容得出的估计更加精确。被要求修改的PR比例和每个PR的审查评论数都大幅上升,而PR大小没有显著变化。因此,评论增加不能用PR变大来解释。
| 指标 | 基准平均值 | 引入智能体的效果 | 如何理解 |
|---|---|---|---|
| PR从提交到合并 | 7.03天 | +3.45天(标准误差1.60) | 显著,但不确定范围较宽 |
| 被要求修改的PR比例 | 0.13 | +0.12(标准误差0.01) | 几乎翻倍 |
| 每个PR的审查评论数 | 1.66条 | +0.58条(标准误差0.11) | 增加35% |
| 每个PR增加的代码行数 | 1,167.97行 | −67.99行(标准误差126.91) | 不显著 |
前面提到的初级工程师在采访中补充道:
“AI生成的提交导致了几次服务中断后,公司又制定了新规定,要求AI生成的代码必须获得高级工程师批准,这让审查瓶颈更加严重。”
也就是说,AI生成的提交引发几次服务中断后,公司规定AI代码必须得到高级工程师批准,审查等待时间因此更长。作者表示,为了让意思清楚,对这段引语做了轻微编辑。
修改请求增加,并不能证明错误也增加了。论文模型将这一变化解读为可能由初稿质量下降引起,即错误率渠道(bug-rate channel),但论文没有提供错误、回滚或服务中断的数量,只有采访中的个例。这一解读也不同于数据提供方的宣传。Jellyfish在2026年1月的博客中介绍预备版本(500家公司、10万人)时写道,“代码质量似乎没有受到影响”。Hacker News上也有人反驳说,瓶颈从一开始就是质量,而不是审查;审查只是质量问题显现的地方。
在同样的人手中,参与审查的工程师比例从0.29升至0.33
公司内部的工作分配也发生了变化。参与审查的工程师比例从0.29增加了0.04,上升14%;编写代码的工程师比例(0.43)则没有显著变化。雇用规模也没有显著变化。估计结果排除了引入智能体后总体雇用人数下降超过2.9%、工程师雇用人数下降超过13.8%的可能性,初级和高级工程师的人数也都没有显著变化。结果显示,公司没有增加招聘,而是在现有人员中让更大比例的人承担审查工作。
AI代码审查工具也迅速普及。截至2026年3月,样本中近80%的公司尝试过AI审查工具。但在全部审查评论中,AI写的占23.3%;收到至少一条AI评论的PR占10.8%。其余76.7%的评论由人撰写。论文认为,即使引入AI审查工具,审查瓶颈仍然存在。
Hacker News上的一名开发者写道,高级工程师很难放弃逐行审查。这名开发者认为,从一开始就不设人工审查的初创公司可能会有不同结果,并指出这类组织不太容易出现在本研究这样的样本中。论文的公开说明没有对这一点进行单独分析。
AI加快了编程速度,但完成工作的速度取决于代码通过人工审查的速度
论文附录中的一名高级工程师这样描述这一结构:
“同一时间只有一个瓶颈。如果加快编程,瓶颈就会转移到别处。……现在你可以快得多地生成功能,但它们仍需要人来验证和批准。”
根据Jellyfish记录估计,工程师将42.0%的工作时间用于编写代码,18.6%用于审查,39.5%用于管理工作。智能体加快的是其中编写代码的部分。但代码要部署,必须经过人工审查。代码增加后,每次审查需要做的工作也增加了。被要求修改的PR几乎翻倍,每个PR的审查评论也增加了35%。公司现有人员中承担审查的人所占比例增加了14%,这些人是转去做审查的,并非新招聘的人员。
把人员转到审查工作是否足够,目前仍不清楚。论文认为,如果瓶颈源于初稿质量,仅靠转移人员做审查无法解决问题,技术本身必须改进。被要求修改的PR几乎翻倍是否意味着质量出现问题,由于缺少错误记录,单凭这篇论文无法判断。无论如何,增加的代码都积压在人工审查环节。
这一结果有时间上的局限。数据截至2026年3月,而Ars Technica指出,此后智能体仍有大幅改进,许多公司还在学习如何使用它们。数据属于专有数据,外部无法复现;通过个人许可证使用的智能体也没有被纳入采用记录。
许多管理者过去关注的是工程师写了多少代码。编程智能体让代码行数增加了30%,但无法认定完成部署的工作有所增加。如今管理者需要关注的是,这些代码通过人工审查有多快,需要经过几轮审查。
想进一步了解
Artificial Intelligence in the Firm: Bottlenecks in Software Production Chen和Stratton的原论文。第4节分析审查瓶颈,附录B收录了对工程师的采访。 fion.ac
Harvard researchers find AI coding agents shifted the bottleneck to code review 一篇批判性文章,探讨了论文与Jellyfish的关系,以及预备版本的宣传与当前版本解读之间的差异。 complexdiscovery.com
AI coding agents generate more code, but not more software 文章介绍了论文中的图表和数字,并补充说明了数据时间范围的局限。 arstechnica.com