2025年5月から2026年2月にかけて、米国の知的財産法律事務所11か所に所属する特許弁護士133人が、それぞれ90日間の実験に参加しました。90人にはGoogleが開発したAI特許文書作成ツールが提供され、43人には提供されませんでした。90日目、研究者は全員にAIが作成した特許草案を渡し、今度はAIを使わずに修正するよう求めました。
AIを使える起草課題では、経験7年未満の若手は、ツールを提供された人の得点が提供されなかった人より大幅に高く、その差はベテランよりも大きくなりました。一方、AIなしの修正試験では、ツールを提供された若手とされなかった若手の間に明確な差は見られませんでした。この試験で、提供されなかった同程度の経験を持つ人を上回ったのは、経験7年以上のベテランだけでした。MITのDavid AutorとGoogleの研究者6人による論文は、2026年9月3日にNBERの初版として公表され、10月7日の改訂版では一部の分析とインタビューの節が削除されました。この記事の数値は改訂版に基づきます。
GoogleとMITの研究者は米国の特許弁護士133人のうち90人にAIツールを提供し、提供しない43人と3か月間比較した
研究者は、法律事務所が推薦した156人のうち133人を、各事務所内で2対1に無作為に振り分けました。処置群の90人には、Google Labsの未公開ツールInFlowとその研修が提供され、対照群の43人は従来の法律ツールだけを使いました。参加者の平均経験年数は12.4年で、経験7年以上のベテランは89人(67%)でした。
- 10日目の起草課題
主請求項、図面、発明者のメモを受け取り、2時間以内に従属請求項と詳細な説明を書きます。処置群はAIを使えます。 - 90日目の起草課題
同じ形式ですが、より難しい課題です。処置群は今回もAIを使えます。 - 90日目の修正試験
全員がAIを使わず、欠陥の多いAI生成の特許草案を修正し、コメントを付けます。
別の法律事務所に所属する特許弁護士2人が、誰の回答かを知らされないまま採点し、5項目をそれぞれ1〜5点で評価しました。
AIを提供された人全員が頻繁に使ったわけではありません。処置群で生成AIを定期的に使うと答えた割合は、毎月の調査3回とも約20%でした。そのため、この記事の数値が示すのは、実際にAIを使った効果ではなく、ツールを提供された効果です。個人別の利用記録は論文にありません。 実験はGoogleが実施し、費用を負担しました。参加した法律事務所はすべてGoogleの特許業務を手がけ、著者7人のうち6人はGoogleの社員または契約者です。 事前登録書には、処置群を2倍の人数にした理由として「Google製品のユーザー獲得目標」(Google product user acquisition goals)が挙げられています。
AIを使える起草課題の平均点が上がったのは、優れた回答が増えたからではなく、弱い回答が減ったからだった
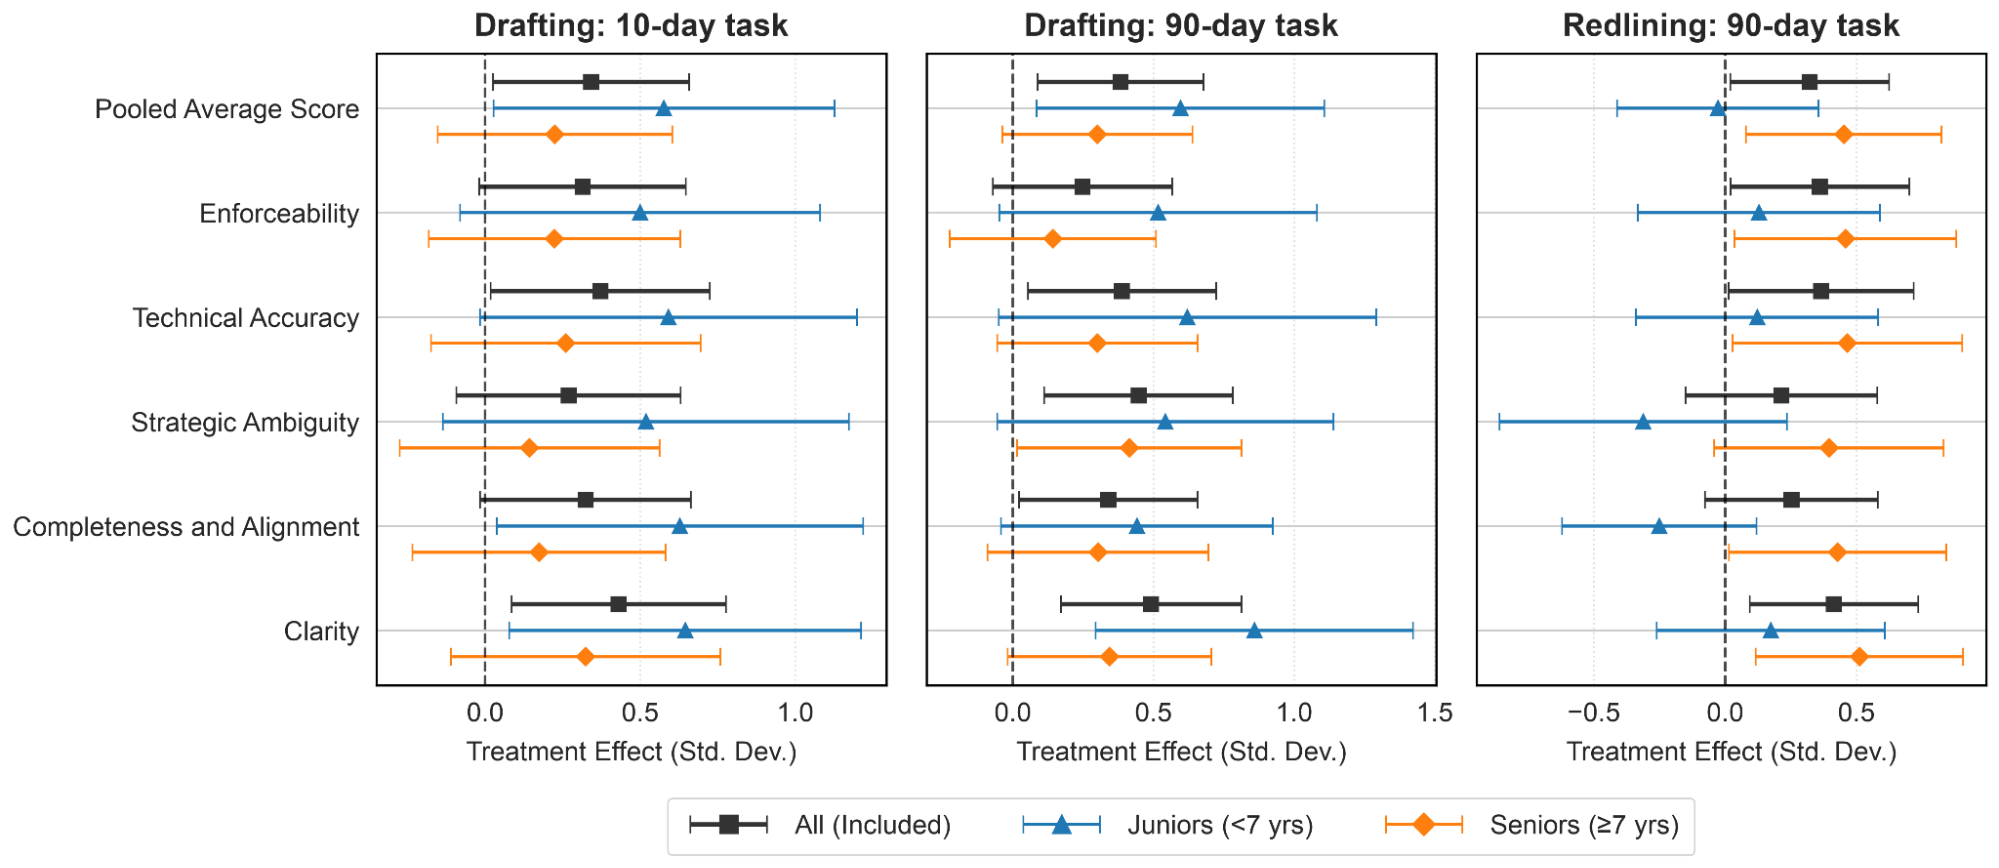
得点差は標準偏差(SD)で示されています。対照群の得点のばらつきを1として、処置群がどれだけ上回ったかを表します。処置群全体は対照群より、10日目の起草で+0.34 SD(p=0.03)、90日目の起草で+0.38 SD(p=0.01)高得点でした。論文は処置群の平均が高かった理由を次のように述べています。
「平均点が高いのは、優れた仕事が増えたからではなく、弱い仕事が減ったからです」。優れた回答が多かったのではなく、弱い回答が少なかったために平均が上がったということです。
AIを提供された若手は、提供されなかった若手より10日目に+0.58 SD、90日目に+0.60 SD高く、ベテランの差はそれぞれ0.22 SD、0.30 SDでした。ただし、Moon Young Kimが執筆するSubstackブログPacific Stackは、この論文への反論で、若手とベテランの効果の差自体は偶然と区別できるほど大きくなく、統計的に有意ではないと指摘しました。
90日目の調査では、AIを提供された若手の起草への満足度は、提供されなかった若手より+1.48 SD高くなりました(p<0.01)。ベテランでは提供された人が+0.28 SD高かったものの(p=0.34)、偶然と区別できませんでした。9月3日の初版は、若手のこの差を自己申告項目の中で最大の効果として挙げています。
AIなしの修正試験では若手の平均に明確な差はなかった一方、AIを提供された若手の採点結果は最下位層で増えた
試験に使われたのは、アクセサリー機器の取り付け部品に関するAI生成の特許草案です。課題には「この課題では、いかなる形でもAIを使用しないでください」と書かれていました。Googleのブログは、この草案には内容と文体の両方に多くの誤りがあったとしていますが、仕込まれた誤りの数や一覧は公開説明にありません。試験を終えたのは91人で、処置群62人、対照群29人でした。
| AIを提供された人と提供されなかった人の得点差(SD) | 全体 | 若手 | ベテラン |
|---|---|---|---|
| 10日目の起草(AI使用可) | +0.34 | +0.58 | +0.22 |
| 90日目の起草(AI使用可) | +0.38 | +0.60 | +0.30 |
| 90日目の修正(AIなし) | +0.32 | −0.03 | +0.45 |
AIを提供された若手と提供されなかった若手の修正得点の差は−0.03 SDでした(置換検定p=0.93)。ただし、試験を終えた若手は24人で、そのうち対照群は7人のため、95%信頼区間は約−0.42〜+0.36と広くなっています。大きな利益とも大きな不利益とも整合する範囲です。実験前の実力試験は法律事務所が拒否したため実施できませんでした。したがって、表の数値は実力の増減幅ではなく、実験終了時の対照群との差です。
研究者は、全参加者の修正試験の採点結果を上から5つの区間に分けました。最上位が第1区間、最下位が第5区間です。AIを提供された若手は、提供されなかった若手より、第4区間(まずまずの得点)に入った採点結果が少なく、第5区間(最下位)に入った採点結果が多くなりました。どちらの差も偶然と区別できるほど明確でした。論文の要旨はこれを若手の得点の二極化としてまとめていますが、第2区間(上から2番目)の採点結果の増加は偶然と区別できませんでした(Pacific Stackの計算でp=0.20)。この比較は、若手24人の修正案に採点者が個別に付けた50件の採点結果に基づきます。
若手の修正案には、欠陥を見つけても直接直さず、「先行詞の根拠に問題がある」といったメモだけを残す例がよく見られました。著者らは、こうしたメモはAIアシスタントへの指示のように読めるとしつつ、AIを提供されなかった対照群の若手にも同じくらい頻繁に見られたと書いています。 インタビューを受けた若手2人は、ツールによって白紙から始める難しさ(blank page problem)がなくなったと話しました。初版はこの発言を得点と照らし合わせ、「若手が自らの成長について語ったことは、AIなしでの成果には反映されていない」と記しました。若手が感じた成長は、AIなしの得点には表れなかったという意味です。
AIなしの試験では、AIを提供されていたベテランが未提供のベテランを上回り、節全体を書き直して修正理由を記した
同じ修正試験で、AIを提供されていたベテランは、提供されなかったベテランより+0.45 SD高得点でした(p=0.02)。提供されていたベテランの得点は、未提供のベテランよりばらつきも小さくなりました。この差は、置換検定(p=0.02)、Gemini 2.5-flashによる再採点(+0.66 SD)、若手とベテランを分ける経験年数の基準を3〜11年に変えた分析でも、同じ方向に出ました。
ただし、留保もあります。研究者はLLMと人による確認を使い、修正試験の回答91件のうち15件でAIが隠れて使われた疑いがあると判断しました。この15件を除くと、ベテランの差は0.39 SDに縮まり、偶然による差である可能性を排除しにくくなります(p≈0.06)。同じ試験の全体の差も0.32 SDから0.25 SDに縮まり、偶然と区別できなくなります(p≈0.14)。
ベテランがどのように修正したかは、9月3日の初版にしか載っていません。研究者がGemini 3.0 ProとNotebookLMで修正案を分析し、処置群の4人にインタビューした節で、10月の改訂版では削除されました。この分析によると、AIを提供されていたベテランは、修正試験で文章を手直しするよりも節全体を書き直しました。権利範囲を狭める表現を取り除き、修正箇所ごとに根拠となる法理を記しました。AIを提供されなかったベテランの修正案とどう違ったのかは、公開説明には見当たりません。ベテランは処置群、対照群のいずれでも、若手よりこの試験に時間をかけました。
インタビューを受けたベテランの1人は、AIの出力を「手強いほどしっかりした初稿」(formidable first draft)、つまり新人アソシエイトの基本的な成果物に匹敵する初稿と呼びました。もう1人はAIを「論理の監査役」(logic auditor)のように使い、自分の戦略の論理を点検したと話しました。2人ともAIが書いた文章をそのまま受け入れず、欠陥はあっても構造の整った草案を扱うことで、見過ごしていたかもしれない論理の隙間を検討するようになったと答えました。Googleのブログはこの変化を「既存の文章への執着を弱め、構造的な修正の理由と方法を言葉にするよう促した」とまとめています。既存の文章に縛られにくくなり、構造を直す理由と方法を説明するようになったということです。
インタビューを受けたベテランは2人だけで、質的分析にはLLMが使われました。そのため、この場面はベテランの得点が高かった原因を示す証拠というより、著者らが数値とともに提示した説明です。
AIを使える起草得点だけでは若手が最も伸びたように見えるが、AIなしの得点は別の姿を示した
9月3日の初版の要旨には「AIによる最大の利益は、その効果を最も保持しなかった弁護士にもたらされた」という一文がありました。AIを使える起草で対照群を最も大きく上回った若手が、AIなしの修正試験では対照群との差が最も小さかったという意味です。10月の改訂版はこの文に代えて、AIは一部の若手には「踏み台」(springboard)となり、別の若手には「クッション」(cushion)となったと書きました。踏み台はAIを足がかりにAIなしでも上達した場合、クッションはAIが難しい部分を支えるため、AIがなければかえって成績が下がる場合を指す比喩です。前節の第5区間(最下位)の採点結果の増加はクッションの説明と整合しますが、踏み台に当たる第2区間の増加は偶然と区別できませんでした。著者らはVoxEUのコラムでも「若手の標本が小さいため、確定的な結論は出せない」と述べています。
表現は慎重になりましたが、改訂版の表でも、AIを使える起草得点の対照群との差は若手のほうがベテランより大きく、AIなしの修正得点で対照群を上回ったのはベテランだけでした。著者らは2つの得点を合算せず、別々に報告しました。実験期間は参加者ごとに3か月で、著者らは結果が2024〜2025年のAI性能を反映するとしています。AIなしの試験でAIを提供された若手が利益を得たのか、不利益を受けたのかは、対照群の若手7人ではまだ判別できません。
AIを使える起草得点だけを見ると、AIを提供された若手が最も大きく上回っているように見えました。AIなしで別に受けた試験では、対照群を上回ったのはAIを提供されていたベテランだけで、若手の差はまだ定かではありません。この実験は、AIを使った成果物から見える成長と、AIなしの試験得点が異なる姿を示すことを明らかにしました。
さらに詳しく知るには
Does better work always mean better workers? 著者のAutorとRodchenkoが、若手とベテランそれぞれの処置効果を示す図とともに結果をまとめた記事です。 research.google
Better work, not always better workers 著者7人が、若手の結果を解釈する際の限界と、結果が反映するAI性能の時期を明示したコラムです。 cepr.org
An AI Drafting Experiment Leaves the Junior Question Open 若手の対照群が7人であることとGoogleの利害関係を根拠に、若手に関する結論はまだ出せないと反論した記事です。 pacificstack.substack.com