从2025年5月到2026年2月,美国11家知识产权律师事务所的133名专利律师各自参加了一项为期90天的实验。其中90人获得了Google开发的AI专利撰写工具,43人没有获得。第90天,研究人员给所有人一份AI生成的专利草稿,要求他们这次不用AI进行修改。
在可以使用AI的起草任务中,执业不足7年的初级律师,获得工具的人比没有获得的人得分高出许多,差距也大于资深律师。但在不用AI的修改测试中,获得工具和没有获得工具的初级律师之间没有呈现明确差异。在这项测试中,只有执业7年以上、获得过工具的资深律师,得分高于没有获得工具的同资历者。MIT的David Autor与Google的6名研究人员合著的论文于2026年9月3日作为NBER工作论文初版发表,10月7日的修订版删去了一些分析和访谈章节。本文数字以修订版为准。
Google和MIT研究人员只向133名美国专利律师中的90人提供AI工具,三个月内与未获工具的43人比较
研究人员从律所推荐的156人中选出133人,在各律所内部按2:1的比例随机分组。处理组90人获得Google Labs尚未发布的工具InFlow及相关培训,对照组43人只使用原有法律工具。参与者平均执业年限为12.4年,其中执业7年以上的资深律师有89人,占67%。
- 第10天起草
参与者拿到主权利要求、图纸和发明人笔记,在2小时内撰写从属权利要求和详细说明。处理组可以使用AI。 - 第90天起草
任务形式相同,但难度更高。处理组这次也可以使用AI。 - 第90天修改测试
所有人都不用AI,修改一份缺陷很多的AI生成专利草稿并添加意见。
另外两家律所的专利律师在不知道答卷者身份的情况下评分,分别对五个项目打1至5分。
获得AI工具的人并非都频繁使用。在三次月度调查中,处理组表示定期使用生成式AI的比例均约为20%。因此,本文数字衡量的是获得AI工具的效果,而不是实际使用AI的效果。论文没有提供个人使用记录。 实验由Google实施并出资。参与律所均为Google处理专利业务,7名作者中有6人是Google员工或承包人员。 预注册文件将“Google产品用户获取目标”(Google product user acquisition goals)列为处理组人数设为对照组两倍的原因之一。
可以使用AI的起草任务得分提高,是因为较差的答卷减少了,而不是优秀答卷增多了
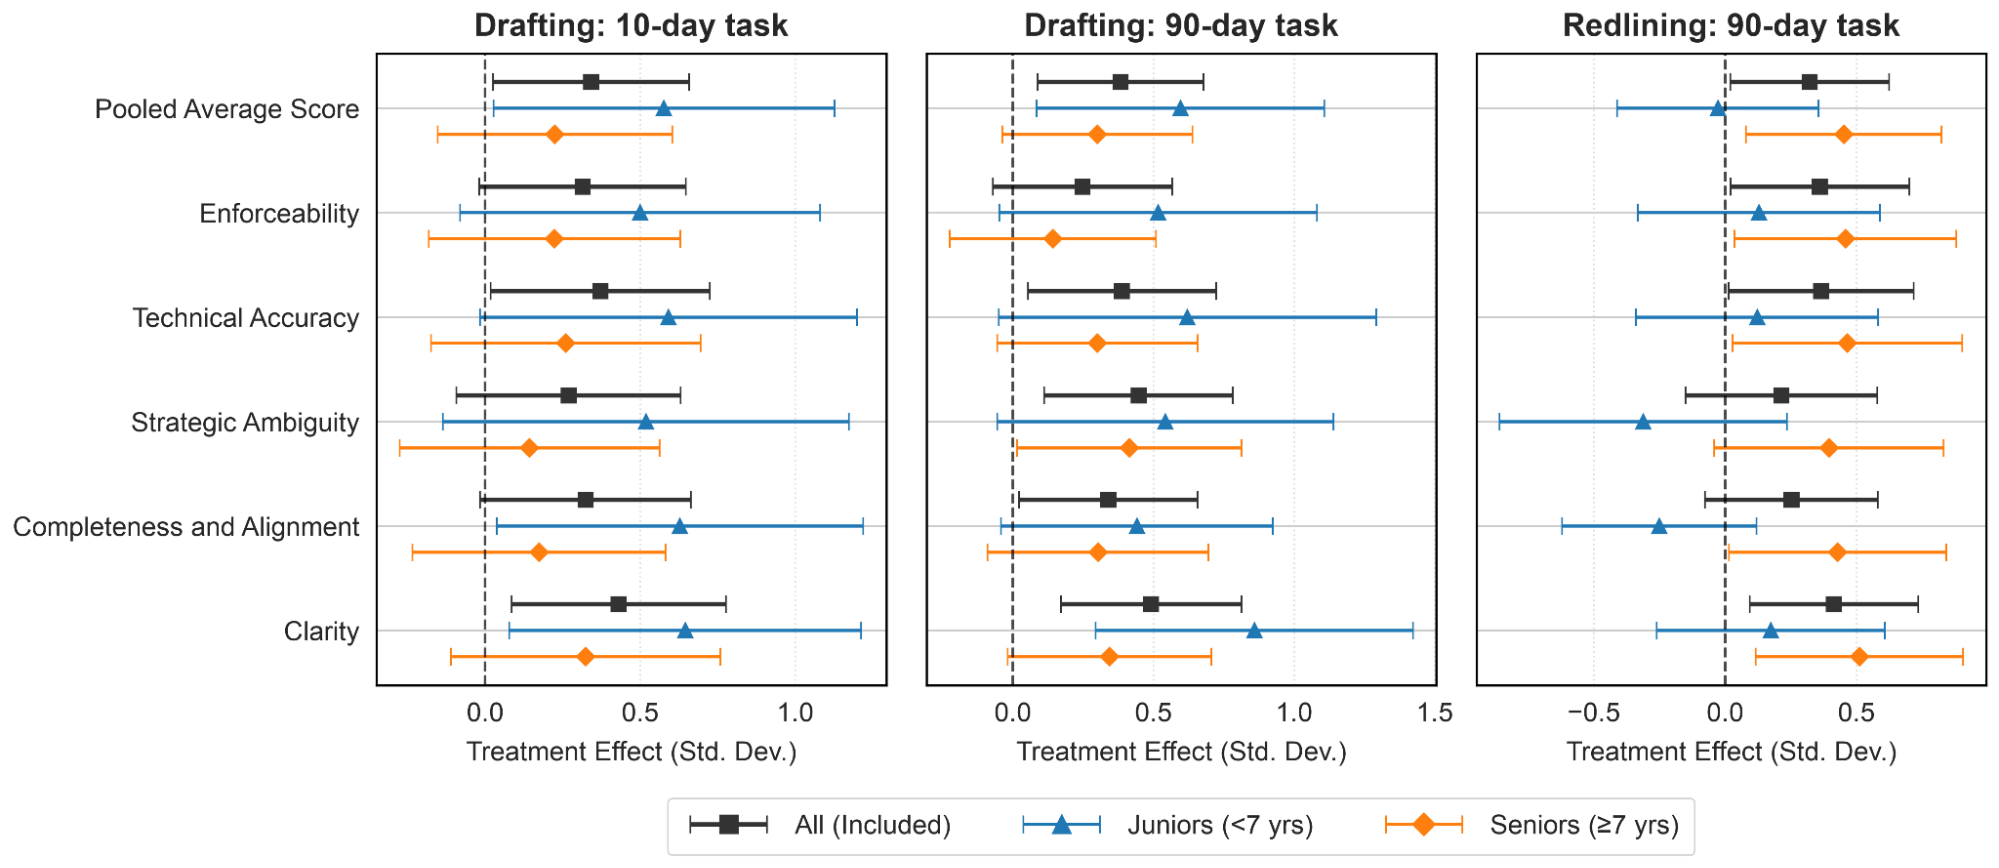
得分差异以标准差(SD)为单位。研究以对照组得分的离散程度为1,表示处理组高出多少。处理组整体在第10天的起草任务中比对照组高+0.34 SD(p=0.03),第90天高+0.38 SD(p=0.01)。论文这样解释处理组平均分较高的原因。
“平均分较高反映的是较差作品减少,而不是优秀作品增多。”也就是说,平均分提高是因为较差答卷更少,而非优秀答卷更多。
获得AI的初级律师比未获得者第10天高+0.58 SD,第90天高+0.60 SD;资深律师的相应差距为0.22 SD和0.30 SD。不过,Moon Young Kim撰写的Substack博客Pacific Stack在一篇反驳文章中指出,初级与资深律师之间的效果差异本身还不够大,无法与偶然波动区分,也就是统计上不显著。
在第90天的调查中,获得AI的初级律师报告的起草满意度比未获得者高+1.48 SD(p<0.01)。获得AI的资深律师比未获得者高+0.28 SD(p=0.34),但这一差异无法与偶然波动区分。9月3日的初版将初级律师的这一差距列为自我报告项目中最大的效果。
不用AI修改时,初级律师的平均分没有明确差异,但获得AI者落入最低档的评分结果增多了
测试材料是一份关于配件设备附着部件的AI生成专利草稿。任务说明写着:“请勿在本任务中使用任何形式的AI。”Google博客称,草稿在内容和文风上都有许多错误,但公开说明没有列出预先设置的错误数量或清单。91人完成了测试,其中处理组62人,对照组29人。
| 获得AI者与未获得者的得分差距(SD) | 整体 | 初级律师 | 资深律师 |
|---|---|---|---|
| 第10天起草(可使用AI) | +0.34 | +0.58 | +0.22 |
| 第90天起草(可使用AI) | +0.38 | +0.60 | +0.30 |
| 第90天修改(不用AI) | +0.32 | −0.03 | +0.45 |
获得AI和未获得AI的初级律师,其修改得分差为−0.03 SD(置换检验p=0.93)。但完成测试的初级律师只有24人,其中对照组仅7人,因此95%置信区间约为−0.42至+0.36,范围很宽,既与显著受益相容,也与显著受损相容。由于律所拒绝,实验前的技能测试未能进行。因此,表中数字并非技能提高或下降的幅度,而是实验结束时与对照组的差距。
研究人员按照全体参与者的修改测试评分结果,从高到低分成五档,最高为第1档,最低为第5档。与未获得AI的初级律师相比,获得AI者落在第4档(得分一般)的评分结果更少,落在第5档(最低档)的结果更多。这两个差异都足够明显,可以与偶然波动区分。论文摘要将其概括为初级律师得分的两极分化,但第2档(从高到低第二档)评分结果的增加无法与偶然波动区分(Pacific Stack计算p=0.20)。这一比较依据的是评分者分别给24名初级律师的修改稿打出的50次评分。
初级律师的修改稿中,经常出现发现缺陷却不直接修正、只留下“存在前置基础问题”等备注的情况。作者表示,这些备注读起来像是给AI助手的指令,但也写道,在没有获得AI的对照组初级律师中,这种情况同样常见。 两名接受访谈的初级律师表示,工具消除了从空白页面开始的困难(blank page problem)。初版将他们的说法与得分相比较,写道:“初级律师对自身成长的描述,并未反映在他们不用AI时的表现中。”也就是说,他们感受到的成长没有体现在不用AI的得分上。
不用AI修改时,获得过工具的资深律师胜过未获工具者,并重写整个章节、说明修改理由
在同一项修改测试中,获得过AI的资深律师比未获得者高+0.45 SD(p=0.02)。获得过AI的资深律师得分也更加集中。这一差异在置换检验(p=0.02)、用Gemini 2.5-flash重新评分(+0.66 SD),以及将初级与资深律师的执业年限分界改为3至11年的分析中,都呈现相同方向。
不过也有一个限制。研究人员通过LLM和人工检查,怀疑91份修改测试答卷中有15份暗中使用了AI。排除这15份后,资深律师的差距缩小至0.39 SD,也更难排除差异由偶然造成的可能性(p≈0.06)。同一测试的整体差距也从0.32 SD降至0.25 SD,无法与偶然波动区分(p≈0.14)。
资深律师如何修改,只见于9月3日的初版。该章节中,研究人员用Gemini 3.0 Pro和NotebookLM分析修改稿,并访谈了处理组的4人;这一章节在10月修订版中被删去。根据这项分析,获得过AI的资深律师在修改测试中更倾向于重写整个章节,而不是润色句子。他们删去了缩小权利范围的措辞,并在每处修改中写明依据的法律原理。公开说明中没有交代这些修改稿与未获得AI的资深律师的修改稿有何不同。无论在处理组还是对照组,资深律师在这项测试上花的时间都比初级律师多。
一名接受访谈的资深律师称AI输出是一份“相当扎实的初稿”(formidable first draft),其扎实程度相当于新入职助理律师的基本成果。另一人说,自己把AI当作“逻辑审查员”(logic auditor),检查自身策略的逻辑。两人都没有原样接受AI写出的句子,并表示处理一份虽有缺陷但结构完整的草稿,使他们开始审视原本可能忽略的逻辑漏洞。Google博客这样概括这一变化:“它削弱了他们对现有文字的依恋,迫使他们说清结构性修改的原因和方法。”也就是说,他们不再那么拘泥于原有句子,并需要解释为什么以及如何调整结构。
接受访谈的资深律师只有2人,定性分析使用了LLM。因此,这些情况更像是作者在数字之外给出的解释,而不是证明资深律师得分领先原因的证据。
只看可用AI的起草得分,初级律师似乎进步最大;不用AI的得分却呈现另一幅图景
9月3日初版摘要中有一句话:“因此,从AI中获益最多的律师,恰恰是保留这些收益最少的人。”意思是,在可用AI的起草任务中比对照组领先最多的初级律师,在不用AI的修改测试中与对照组的领先差距最小。10月修订版用另一种说法取代了这句话:AI对一些初级律师是“跳板”(springboard),对另一些人则是“缓冲垫”(cushion)。跳板指借助AI后,不用AI也能做得更好的情况;缓冲垫指AI支撑了困难部分,以至于没有AI时反而表现更差。上一节提到的第5档(最低档)评分结果增加,与缓冲垫的解释相符;对应跳板解释的第2档评分结果增加,则无法与偶然波动区分。作者在VoxEU专栏中也写道:“由于初级律师样本较小,我们无法得出确定结论。”
措辞虽然变得更加谨慎,修订版表格仍显示:在可用AI的起草任务中,初级律师相对对照组的领先幅度大于资深律师;在不用AI的修改测试中,只有资深律师领先各自的对照组。作者没有将两种得分合并,而是分别报告。每位参与者的实验期为三个月,作者表示结果反映的是2024至2025年的AI性能。初级律师对照组只有7人,因此还无法判断获得AI的初级律师在不用AI的测试中究竟受益还是受损。
只看可用AI的起草得分,获得工具的初级律师似乎领先最多。在单独进行的无AI测试中,只有获得过工具的资深律师领先对照组,初级律师的差异仍不确定。这项实验表明,从AI辅助成果中看到的成长,与不用AI的测试得分可能讲述不同的故事。
想了解更多
Does better work always mean better workers? 作者Autor和Rodchenko结合初级与资深律师处理效果的图表,总结了研究结果。 research.google
Better work, not always better workers 7名作者在这篇专栏中直接说明了初级律师结果的解释限制,以及研究所反映的AI性能时期。 cepr.org
An AI Drafting Experiment Leaves the Junior Question Open 这篇反驳文章以初级律师对照组只有7人和Google的利益关系为依据,认为有关初级律师的结论仍待确定。 pacificstack.substack.com