2025년 5월부터 2026년 2월까지, 미국 지식재산 로펌 11곳의 특허 변호사 133명이 한 사람당 90일씩 실험에 참여했어요. 90명은 Google이 만든 AI 특허 작성 도구를 받았고, 43명은 받지 않았어요. 90일째에 연구진은 모두에게 AI가 쓴 특허 초안 한 편을 주고, 이번에는 AI 없이 고치라고 했어요.
AI를 켜고 쓴 초안 점수에서, 경력 7년이 안 된 저연차는 AI를 받은 쪽이 받지 않은 쪽보다 크게 높았고 그 폭은 선배 쪽보다 컸어요. 그런데 AI 없이 고친 시험에서는 AI를 받은 저연차와 받지 않은 저연차 사이에 차이가 보이지 않았어요. 이 시험에서 AI를 받지 않은 같은 연차보다 앞선 쪽은 7년 이상 선배뿐이었어요. David Autor(MIT)와 Google 연구진 6명이 쓴 이 논문은 2026년 9월 3일 NBER 초판으로 처음 나왔고, 10월 7일 개정판에서 일부 분석과 면담 절이 빠졌어요. 이 글의 숫자는 개정판 기준이에요.
Google과 MIT 연구진이 미국 특허 변호사 133명 가운데 90명에게만 AI 특허 작성 도구를 주고, 석 달 동안 AI를 받지 않은 43명과 견줬어요
연구진은 로펌들이 추천한 156명 가운데 133명을 로펌 안에서 2:1로 무작위로 나눴어요. 처치군 90명은 Google Labs의 미출시 도구 InFlow와 그 교육을 받았고, 대조군 43명은 기존 법률 도구만 썼어요. 참가자 평균 경력은 12.4년이고, 7년 이상 선배가 89명(67%)이었어요.
- 10일째 초안 쓰기
주 청구항과 도면, 발명자 메모를 받아 2시간 안에 종속 청구항과 상세 설명을 써요. 처치군은 AI를 쓸 수 있어요. - 90일째 초안 쓰기
같은 형식이지만 더 어렵게 낸 과제예요. 처치군은 이번에도 AI를 쓸 수 있어요. - 90일째 수정 시험
모두가 AI 없이, 결함이 많은 AI 생성 특허 초안을 고치고 의견을 달아요.
채점은 다른 로펌의 특허 변호사 2명이 누구 답안인지 모르는 채로 했고, 다섯 항목을 각각 1~5점으로 매겼어요.
AI를 받은 사람이 모두 AI를 많이 쓰지는 않았어요. 처치군에서 생성형 AI를 정기적으로 쓴다고 답한 비율은 세 번의 월간 설문에서 모두 약 20%였어요. 그래서 이 글의 숫자는 모두 실제로 AI를 쓴 효과가 아니라, AI 도구를 받게 한 효과예요. 개인별 사용 기록은 논문에 없어요. 실험은 Google이 수행하고 비용을 댔어요. 참여 로펌은 모두 Google 특허 일을 하고, 저자 7명 가운데 6명이 Google 직원이거나 계약자예요. 사전등록서는 처치군을 두 배로 둔 이유에 “Google product user acquisition goals”(Google 제품 사용자 확보 목표)를 적었어요.
AI를 켠 초안 점수가 오른 건, 뛰어난 답안이 늘어서가 아니라 약한 답안이 줄어서였어요
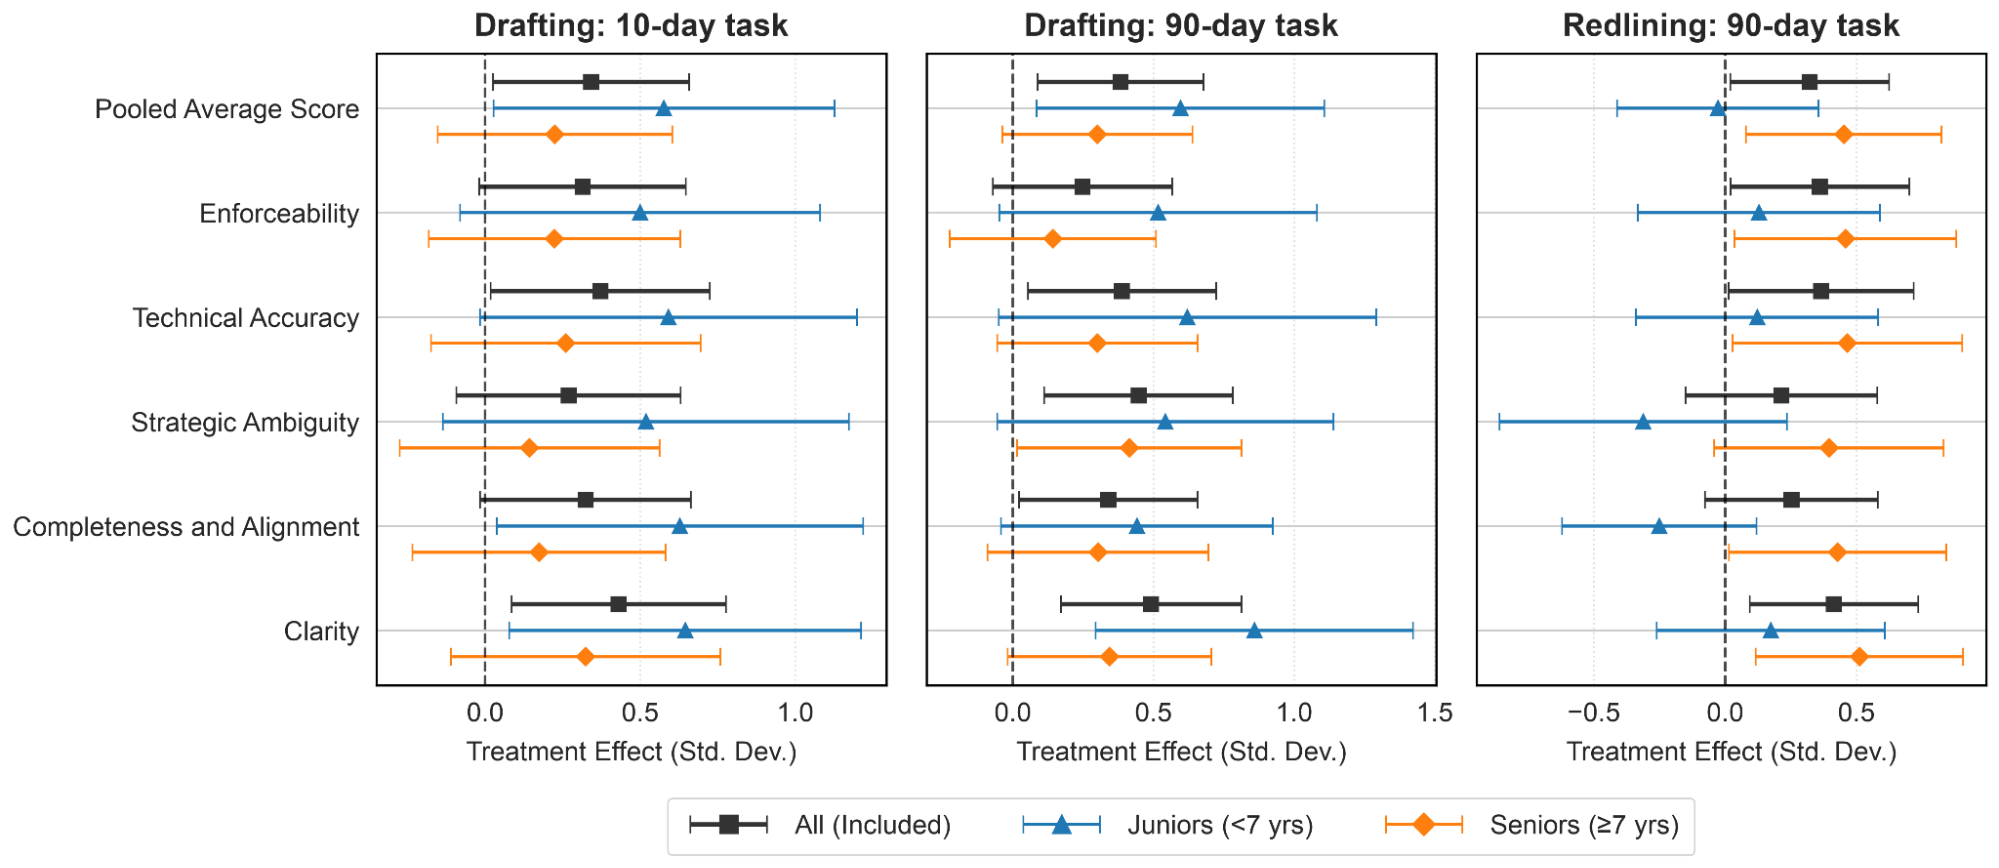
점수는 표준편차(SD) 단위예요. 대조군 점수가 흩어진 폭을 1로 놓고, 처치군이 얼마나 위에 있는지를 나타내요. 처치군 전체는 대조군보다 10일째 초안에서 +0.34 SD(p=0.03), 90일째 초안에서 +0.38 SD(p=0.01) 높았어요. 논문은 처치군 평균이 높은 까닭을 이렇게 적었어요.
“Higher average scores reflect lower prevalence of weak work, not higher prevalence of excellent work.” 뛰어난 답안이 많아서가 아니라 약한 답안이 적어서 평균이 높았다는 뜻이에요.
AI를 받은 저연차는 받지 않은 저연차보다 10일째 +0.58 SD, 90일째 +0.60 SD 높았고, AI를 받은 선배는 받지 않은 선배보다 0.22 SD와 0.30 SD 높았어요. 다만 Moon Young Kim이 쓰는 Substack 블로그 Pacific Stack은 이 논문을 반박한 글에서, 저연차와 선배의 효과 차이 자체는 우연과 구별될 만큼 크지 않다고(통계적으로 유의하지 않다고) 지적했어요.
90일째 설문에서 AI를 받은 저연차가 답한 초안 쓰기 만족도는 받지 않은 저연차보다 +1.48 SD(p<0.01) 높았어요. AI를 받은 선배는 받지 않은 선배보다 +0.28 SD(p=0.34) 높았지만 우연과 구별되지 않았어요. 9월 3일에 낸 초판은 저연차의 이 차이를 자기보고 문항 가운데 가장 큰 효과로 꼽았어요.
AI 없이 고친 시험에서 AI를 받은 저연차는 평균으론 받지 않은 쪽과 갈리지 않았지만, 맨 아래 구간에 든 채점 결과가 늘었어요
시험지는 액세서리 기기의 부착 부품에 관한 AI 생성 특허 초안이었고, 과제지에는 “Please DO NOT use any form of AI for this task.”라고 적혀 있었어요. Google 블로그는 이 초안에 내용과 문체 양쪽으로 오류가 많았다고 썼지만, 심어 둔 오류의 개수와 목록은 공개 설명에 없어요. 91명(처치군 62명, 대조군 29명)이 이 시험을 끝냈어요.
| AI를 받은 쪽이 받지 않은 쪽보다 높은 폭(SD) | 전체 | 저연차 | 선배 |
|---|---|---|---|
| 10일째 초안(AI 사용) | +0.34 | +0.58 | +0.22 |
| 90일째 초안(AI 사용) | +0.38 | +0.60 | +0.30 |
| 90일째 수정(AI 없음) | +0.32 | −0.03 | +0.45 |
AI를 받은 저연차와 받지 않은 저연차의 수정 점수 차이는 −0.03 SD(순열검정 p=0.93)였어요. 다만 수정 시험을 끝낸 저연차는 24명이고 그중 대조군은 7명이라, 이 차이의 95% 신뢰구간이 약 −0.42~+0.36으로 넓어요. 상당한 이득과도, 상당한 손해와도 맞는 범위예요. 실험 전 실력 시험은 로펌들이 거부해 하지 못했어요. 그래서 표의 숫자는 모두 실력이 늘거나 준 폭이 아니라, 끝 시점에 대조군과 견준 차이예요.
연구진은 수정 시험 채점 결과를 전체 참가자 기준으로 위에서부터 다섯 구간으로 나눴어요. 맨 위가 1구간, 맨 아래가 5구간이에요. AI를 받은 저연차는 받지 않은 저연차보다 4구간(그저 그런 점수)에 든 채점 결과가 적었고, 5구간(맨 아래)에 든 채점 결과가 많았어요. 두 차이는 우연과 구별될 만큼 뚜렷했어요. 논문 초록은 이것을 저연차 점수가 위아래로 갈린 모습으로 묶었지만, 2구간(위에서 둘째)에 든 채점 결과가 많아진 것은 우연과 구별되지 않았어요(Pacific Stack 계산 p=0.20). 이 비교는 저연차 24명의 수정본에 채점자마다 따로 매긴 채점 결과 50건에 기대요.
저연차 수정본에서는 결함을 찾고도 직접 고치지 않고 “there are antecedent basis issues” 같은 메모만 남긴 경우가 잦았어요. 저자들은 이 메모가 AI 비서에게 내리는 지시처럼 읽힌다고 하면서도, AI를 받지 않은 대조군 저연차에게서도 똑같이 흔했다고 썼어요. 면담한 저연차 2명은 도구가 빈 화면에서 시작하는 어려움(“blank page problem”)을 없애 줬다고 말했어요. 초판은 이 말을 점수와 맞대어 “Juniors' accounts of their own development are not reflected in their performance absent AI.”라고 적었어요. 저연차가 느낀 성장이 AI 없는 점수에는 나타나지 않았다는 뜻이에요.
AI 없이 고친 시험에서는 AI를 받았던 선배가 받지 않은 선배보다 잘 고쳤고, 절 전체를 다시 쓰며 고친 이유를 적었어요
같은 수정 시험에서 AI를 받았던 선배는 받지 않은 선배보다 +0.45 SD(p=0.02) 잘 고쳤어요. AI를 받았던 선배의 점수는 받지 않은 선배의 점수보다 더 고르게 모이기도 했어요. 이 차이는 순열검정(p=0.02), Gemini 2.5-flash로 다시 채점한 결과(+0.66 SD), 저연차와 선배를 가르는 경력 기준을 3~11년으로 바꾼 분석에서도 같은 방향으로 나왔어요.
단서도 있어요. 연구진은 수정 시험 답안 91건 가운데 15건을 LLM과 사람 점검으로 AI를 몰래 썼다고 의심했어요. 이 15건을 빼고 다시 보면 선배 차이는 0.39 SD로 줄고, 우연으로 생긴 차이일 가능성을 배제하기 어려워져요(p≈0.06). 같은 시험의 전체 차이도 0.32 SD에서 0.25 SD로 줄어, 우연과 구별되지 않아요(p≈0.14).
선배들이 어떻게 고쳤는지는 9월 3일 초판에만 나와요. 연구진이 Gemini 3.0 Pro와 NotebookLM으로 수정본을 분석하고 처치군 4명을 면담한 절인데, 10월 개정판에서는 빠졌어요. 이 분석에 따르면 AI를 받았던 선배들은 수정 시험에서 문장을 손보기보다 절 전체를 다시 썼어요. 권리 범위를 좁히는 표현을 빼고, 고친 곳마다 근거가 되는 법리를 적었어요. AI를 받지 않은 선배의 수정본이 이와 어떻게 달랐는지는 공개 설명에서 찾을 수 없어요. 선배는 처치군과 대조군 모두에서 저연차보다 이 시험에 시간을 더 썼어요.
면담한 선배 한 명은 AI 출력을 “formidable first draft”, 곧 신입 어소시에이트의 기본 결과물만큼 탄탄한 첫 초안이라고 불렀어요. 다른 한 명은 AI를 “logic auditor”처럼 써서 자기 전략 논리를 점검했다고 했어요. 두 사람 모두 AI가 쓴 문장을 그대로 받아들이지 않았고, 결함은 있지만 구조는 갖춘 초안을 놓고 일하다 보니 그냥 넘어갔을 논리 빈틈을 따지게 됐다고 답했어요. Google 블로그는 이 변화를 “It weakened attachment to existing prose and forced them to articulate the why and how of structural edits.”로 정리했어요. 기존 문장에 덜 매이게 하고, 구조를 고치는 이유와 방법을 말로 설명하게 했다는 뜻이에요.
면담한 선배는 2명뿐이고, 질적 분석은 LLM으로 했어요. 그래서 이 장면은 선배 점수가 앞선 원인을 보여 주는 증거라기보다, 저자들이 숫자 옆에 내놓은 설명이에요.
AI를 켠 초안 점수만 보면 저연차가 가장 크게 성장한 것처럼 보이지만, AI 없이 치른 점수는 다른 그림을 보여 줬어요
9월 3일 초판 초록에는 “The largest gains from AI thus accrued to the lawyers who retained the least.”라는 문장이 있었어요. AI를 켠 초안에서 대조군보다 가장 크게 앞선 저연차가, AI 없이 치른 수정 시험에서는 대조군보다 앞선 차이가 가장 작았다는 뜻이에요. 10월 개정판은 이 문장 대신, AI가 어떤 저연차에게는 “springboard”(발판)였고 다른 저연차에게는 “cushion”(쿠션)이었다고 썼어요. 발판은 AI를 딛고 AI 없이도 더 잘하게 된 경우를, 쿠션은 AI가 힘든 부분을 받쳐 줘서 AI가 없으면 오히려 처지는 경우를 가리키는 비유예요. 앞 절에서 본 5구간(맨 아래) 채점 결과가 많아진 것은 쿠션 쪽과 맞고, 발판 쪽에 해당하는 2구간 채점 결과가 많아진 것은 우연과 구별되지 않았어요. 저자들은 VoxEU 칼럼에서도 “While our small sample of juniors does not allow for definitive conclusions”라고 써서, 저연차 표본이 작아 확정적인 결론을 낼 수 없다고 밝혔어요.
표현은 조심스러워졌지만, 개정판 표에서도 AI를 켠 초안 점수는 저연차가 대조군보다 앞선 폭이 선배보다 컸고, AI 없이 고친 점수에서는 선배만 대조군보다 앞섰어요. 저자들은 두 점수를 하나로 합치지 않고 따로 보고했어요. 실험 기간은 참가자마다 석 달이었고, 저자들은 이 결과가 2024~2025년 AI 성능을 반영한다고 밝혔어요. AI 없이 치른 시험에서 AI를 받은 저연차가 이득을 봤는지 손해를 봤는지는, 대조군 저연차 7명으로는 아직 가려지지 않았어요.
AI를 켠 초안 점수만 보면, AI를 받은 저연차가 가장 크게 앞서 보였어요. AI 없이 따로 치른 시험에서는 AI를 받았던 선배만 앞섰고, 저연차 쪽 차이는 아직 가려지지 않았어요. 이 실험은 AI를 켜고 낸 결과물로 본 성장과 AI 없이 치른 시험 점수가 서로 다른 이야기를 할 수 있다는 것을 보여 줬어요.